Google, OpenAI, Microsoft, Anthropic cùng nhận một tín hiệu “đừng lấy nội dung tôi để huấn luyện AI”
Ngày 30/10/2026, Google, OpenAI và Microsoft cùng công bố sẽ tôn trọng một tín hiệu chung trong file robots.txt, cho phép chủ website nói “không” với việc dùng nội dung để huấn luyện AI tạo sinh chỉ bằng một nhóm lệnh. Đề xuất do Kevin Kelley của Anthropic viết và gửi lên IETF, tổ chức đặt chuẩn kỹ thuật cho Internet, và Anthropic đã bắt đầu hỗ trợ. Trước giờ muốn từ chối, bạn phải liệt kê từng con bot của từng hãng. Giờ là một dòng, nhưng phải chờ đến năm sau.
Tín hiệu mới viết thế nào
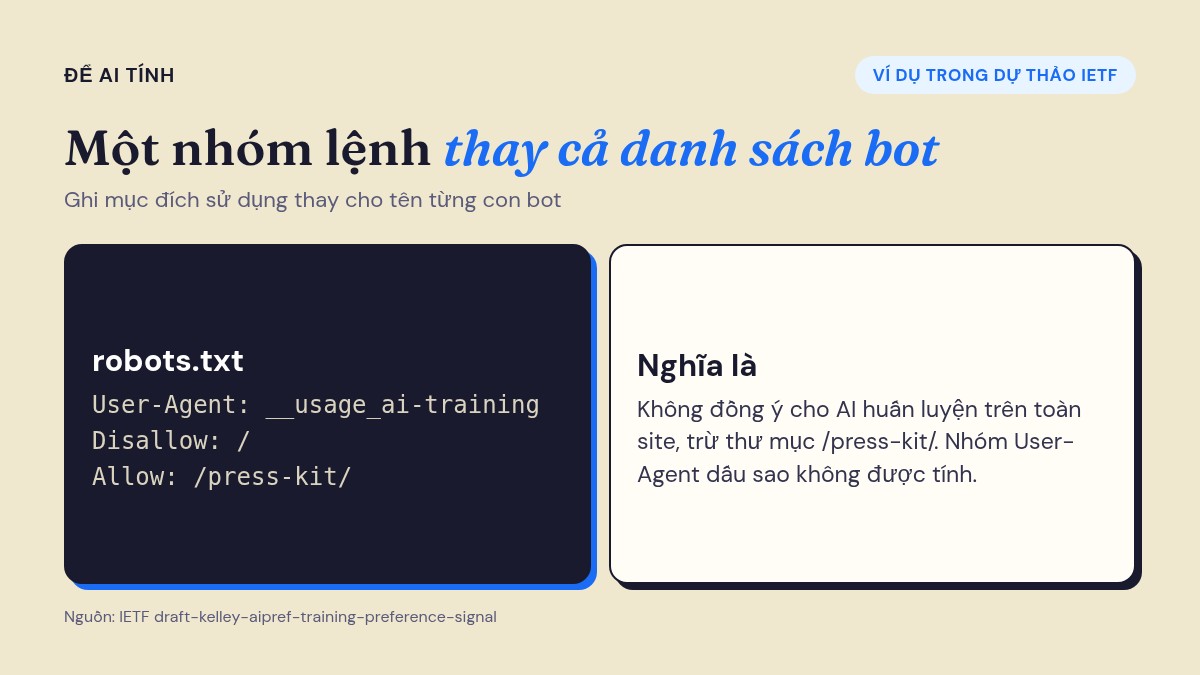
Bản dự thảo mang tên draft-kelley-aipref-training-preference-signal. Ý tưởng rất gọn: thay vì ghi tên một con bot ở dòng User-Agent, bạn ghi một “policy token”, tức một mã chỉ mục đích sử dụng. Ví dụ trong chính dự thảo:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Nhóm lệnh này có nghĩa: không đồng ý cho AI huấn luyện trên toàn site, trừ thư mục /press-kit/. Cú pháp robots.txt giữ nguyên, nên các trình đọc cũ gặp nhóm này sẽ bỏ qua như một con bot lạ.
Ba chi tiết dễ hiểu nhầm
Thứ nhất, nhóm User-Agent dấu sao (*) không được tính. Một file chỉ có “User-Agent: *” được coi là chưa bày tỏ ý muốn gì về huấn luyện AI.
Thứ hai, đây là tín hiệu về cách dùng nội dung, không phải lệnh cấm bot vào trang. Nó không chặn thu thập dữ liệu nói chung và không làm bạn biến mất khỏi Google Search.
Thứ ba, tín hiệu chỉ có tác dụng từ nay về sau. Nội dung đã bị thu thập trước đó thì các hãng vẫn có.
Ai áp dụng, từ khi nào
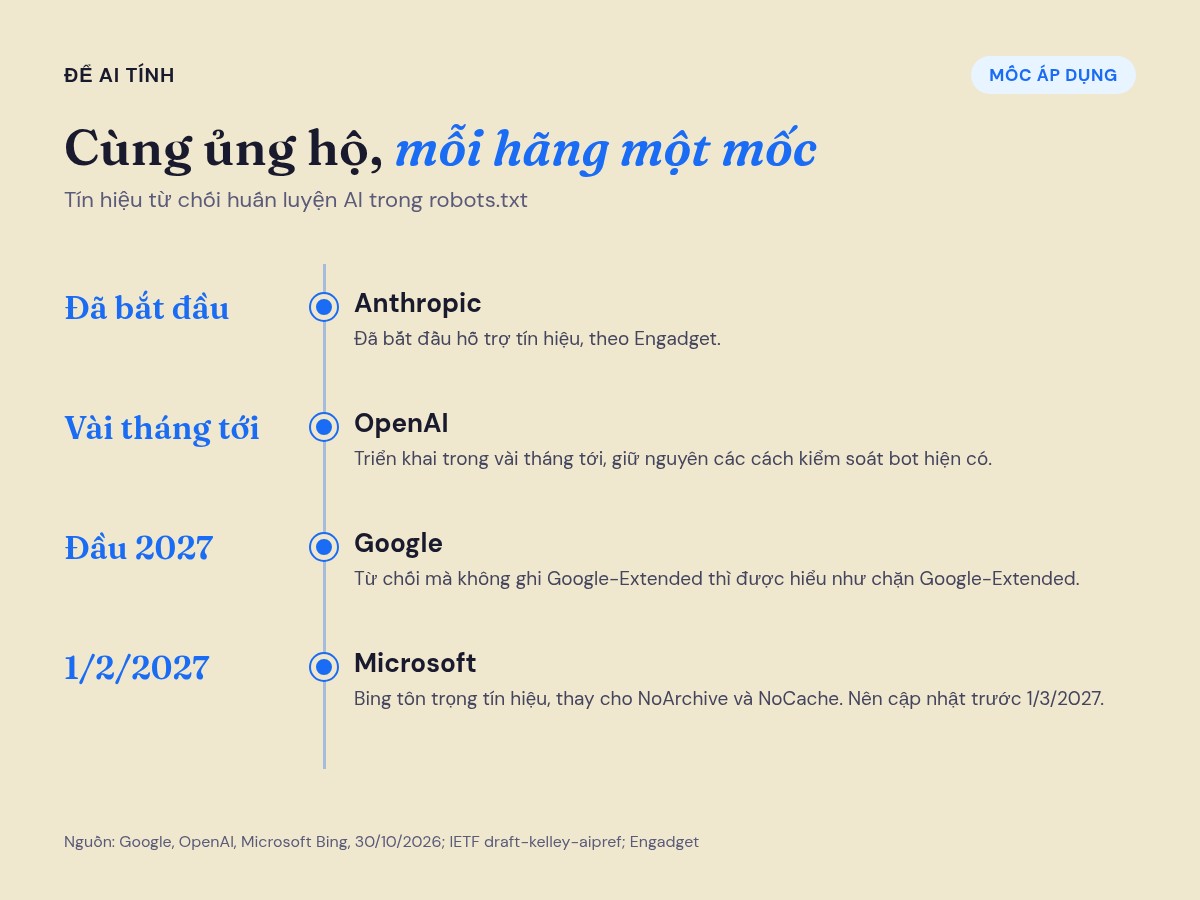
Bốn hãng cùng ủng hộ, nhưng mỗi hãng một mốc:
- Anthropic: theo Engadget, công ty đã bắt đầu hỗ trợ tín hiệu này.
- OpenAI: dự kiến triển khai “trong vài tháng tới”. Các cách kiểm soát bot hiện có của OpenAI vẫn giữ nguyên.
- Google: dự kiến hỗ trợ trong năm 2027, tài liệu bot của Google ghi đầu năm 2027. Nếu site dùng tín hiệu này để từ chối mà không ghi riêng Google-Extended, Google sẽ hiểu như đã chặn Google-Extended.
- Microsoft: tôn trọng từ 1/2/2027 khi Bing thu thập. Tín hiệu mới thay cho cách dùng NoArchive, NoCache trước đây, và Microsoft khuyên cập nhật trước 1/3/2027.
Meta ủng hộ ý tưởng qua phát ngôn viên nhưng chưa cam kết áp dụng. Một điểm quan trọng nữa: dự thảo là bản đề xuất cá nhân, IETF chưa chính thức thông qua.
Vì sao đáng để ý
Microsoft tách riêng hai khái niệm mà nhiều người đang gộp làm một. Huấn luyện là dùng nội dung để dạy mô hình. Grounding là khi câu trả lời AI lấy thông tin từ trang web đang có và dẫn link về nguồn. Microsoft cho đặt lựa chọn grounding ở từng trang, và nói thẳng: chặn grounding sẽ làm nội dung ít xuất hiện trong trải nghiệm AI hơn hẳn. Microsoft cũng ghi rằng không lựa chọn nào bảo đảm được hiển thị, có traffic hay được trả tiền.
Phía Google cũng nói tương tự: site cho phép Google-Extended thì đủ điều kiện xuất hiện trong câu trả lời và nhận lượt nhấp qua Gemini Apps.
Nói cách khác, đây không phải nút “bảo vệ nội dung” miễn phí. Mỗi lựa chọn là một cuộc đổi chác giữa quyền kiểm soát và độ hiện diện trong các câu trả lời AI.
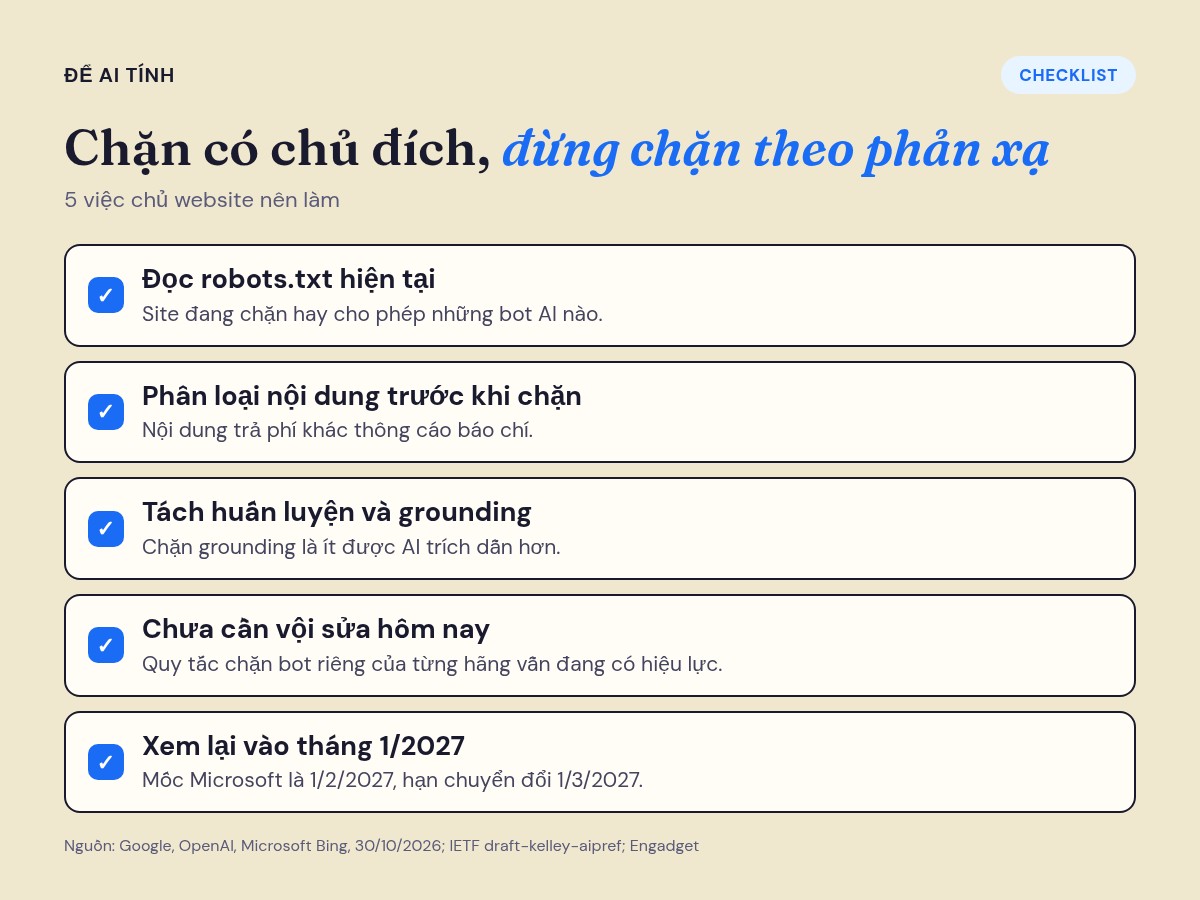
Người làm truyền thông nên làm gì
1. Mở robots.txt hiện tại ra đọc. Ghi lại site đang chặn hay cho phép những bot AI nào. Rất nhiều site sửa file này một lần rồi quên.
2. Phân loại nội dung trước khi chặn. Bài nghiên cứu độc quyền, khoá học, ebook trả phí có thể nên từ chối huấn luyện. Thông cáo báo chí, trang giới thiệu, bài hướng dẫn muốn được AI nhắc đến thì cân nhắc cho phép, giống thư mục /press-kit/ trong ví dụ.
3. Đừng chặn grounding theo phản xạ. Nếu mục tiêu là được AI trích dẫn và dẫn link về, chặn grounding là tự rút mình khỏi cuộc chơi.
4. Chưa cần vội sửa hôm nay. Google và Microsoft chưa áp dụng trước năm 2027. Thêm nhóm lệnh sớm không hại gì, nhưng các quy tắc chặn bot riêng của từng hãng vẫn là thứ đang có hiệu lực.
5. Đặt lịch xem lại vào tháng 1/2027. Mốc Microsoft là 1/2/2027 và hạn chuyển đổi là 1/3/2027. Nếu site đang dùng NoArchive hoặc NoCache, đây là việc phải làm.
Câu hỏi thường gặp
Thêm tín hiệu này có làm tụt hạng Google hay Bing không?
Theo Google và Microsoft, tín hiệu chỉ liên quan đến huấn luyện AI, không thay đổi việc xuất hiện trên Google Search hay thứ hạng Bing.
Chặn rồi thì nội dung cũ có bị xoá khỏi mô hình không?
Không. Tín hiệu chỉ áp dụng cho việc thu thập về sau, không xoá dữ liệu đã thu thập.
Có phải chuẩn chính thức chưa?
Chưa. Đây là bản dự thảo cá nhân ở IETF, các hãng tự nguyện cam kết tôn trọng.
Hoàng Nhật Mai – Founder hệ thống Để AI Tính
Nguồn tham khảo
- Google Search Central Blog, Supporting a shared AI training control for websites (30/10/2026): https://developers.google.com/search/blog/2026/10/ai-training-control
- OpenAI, Making it easier for websites to express AI training preferences (30/10/2026): https://openai.com/index/helping-websites-express-ai-training-preferences/
- Microsoft Bing Blog, Your content, your choice: clearer preferences for training and grounding (30/10/2026): https://blogs.bing.com/search/2026/10/your-content-your-choice-clearer-preferences-for-training-and-grounding/
- IETF, draft-kelley-aipref-training-preference-signal-00: https://datatracker.ietf.org/doc/html/draft-kelley-aipref-training-preference-signal
- Engadget, phần Anthropic và mốc thời gian các hãng (31/10/2026): https://www.engadget.com/2303225/google-openai-anthropic-ai-crawling-controls/
- CNA (AFP), phát ngôn của Meta (31/10/2026): https://www.channelnewsasia.com/world/ai-giants-promise-publishers-new-way-block-some-scraping-6509181
Tư vấn, Trao đổi & Hợp tác
Bạn muốn ứng dụng AI vào công việc, đặt lịch coaching 1-1 hay hợp tác truyền thông? Hãy gửi thông tin cho tôi.
Công cụ AI liên quan
Tin liên quan
Gemini trong Google Slides giờ sửa cả bộ slide một lần, không phải từng trang
📅 01/11/2026
ChatGPT Ads bắt đầu tự viết lại quảng cáo của bạn, và không hỏi trước
📅 01/11/2026
ElevenLabs ra SFX v3: hiệu ứng âm thanh AI bớt rè, hiểu lệnh nhiều tiếng một lúc
📅 30/10/2026