Meta có quét website của bạn không? Cách kiểm tra và chặn bot AI của Meta
Bạn có website, có fanpage, thỉnh thoảng chạy quảng cáo. Câu hỏi tuần này nhiều người nhắn tôi nhất là: Meta có đang lấy nội dung website của mình để làm AI không? Bài này trả lời ngắn gọn: bot nào của Meta vào web bạn, xem ở đâu để biết, chặn thế nào cho đúng, và điều khoản mới của Meta đang ở đâu.
Tóm tắt nhanh
- Meta công bố 5 bot thu thập web. Bot dùng cho việc huấn luyện mô hình AI là meta-externalagent.
- Muốn biết bot Meta đã vào chưa, xem log truy cập trên hosting và tìm tên các bot này.
- Muốn chặn, thêm vài dòng vào robots.txt. Đừng chặn facebookexternalhit, kẻo link chia sẻ lên Facebook mất ảnh xem trước.
- Điều khoản thương mại mới của Meta chưa có hiệu lực. Ngày 28/10/2026, Meta nói có thể lùi qua mốc 20/11, và điều khoản hiện tại vẫn áp dụng.
Bối cảnh, cập nhật ngày 30/10/2026
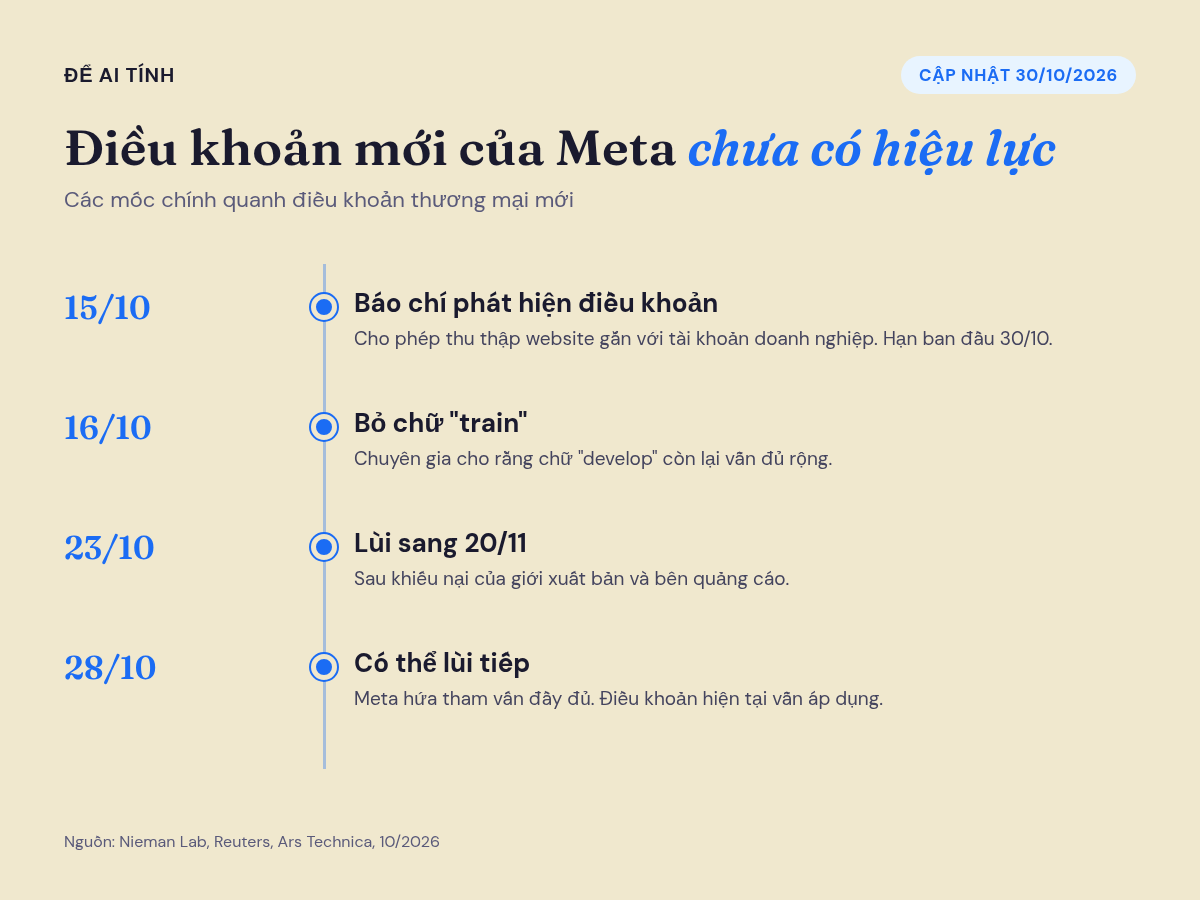
- 15/10: Nieman Lab đưa tin điều khoản thương mại mới của Meta cho phép thu thập tự động nội dung từ website “gắn với” tài khoản doanh nghiệp. Ngày hiệu lực ban đầu là 30/10.
- 16/10: Meta bỏ chữ “train” (huấn luyện) khỏi điều khoản. Chuyên gia pháp lý cho rằng chữ “develop” (phát triển) còn lại vẫn có thể bao gồm việc huấn luyện.
- 23/10: Meta lùi ngày hiệu lực sang 20/11/2026, theo Reuters và Nieman Lab.
- 28/10: Phó chủ tịch truyền thông Andy Stone nói Meta sẽ tham vấn đầy đủ giới xuất bản, có thể lùi tiếp sau 20/11. “Cho đến lúc đó, điều khoản hiện tại vẫn áp dụng.” Cùng ngày, một toà án Na Uy chặn điều khoản mới có hiệu lực ở nước này cho đến khi xem xét xong tính hợp pháp, theo NRK.
Trang điều khoản chính thức của Meta, khi tôi kiểm tra hôm nay, vẫn ghi ngày hiệu lực là 20/11/2026.
Meta dùng những bot nào để quét website?
Theo tài liệu Web Crawlers trên trang dành cho nhà phát triển của Meta (cập nhật ngày 21/5/2026), có 5 bot. Tên dưới đây là tên chính xác bạn sẽ thấy trong log và dùng trong robots.txt.
| Tên bot | Meta dùng để làm gì | Có tuân theo robots.txt? |
|---|---|---|
| meta-externalagent | Huấn luyện mô hình AI nền tảng, hoặc cải thiện sản phẩm bằng cách lập chỉ mục nội dung | Có |
| meta-externalads | Sản phẩm quảng cáo và kinh doanh của Meta | Có |
| meta-webindexer | Tìm kiếm trên Meta AI, giúp Meta AI trích dẫn và dẫn link về web của bạn | Có |
| meta-externalfetcher | Lấy một trang khi người dùng yêu cầu | Có thể bỏ qua |
| facebookexternalhit | Lấy tiêu đề, ảnh, mô tả để hiện xem trước khi có người chia sẻ link | Có thể bỏ qua khi kiểm tra bảo mật |
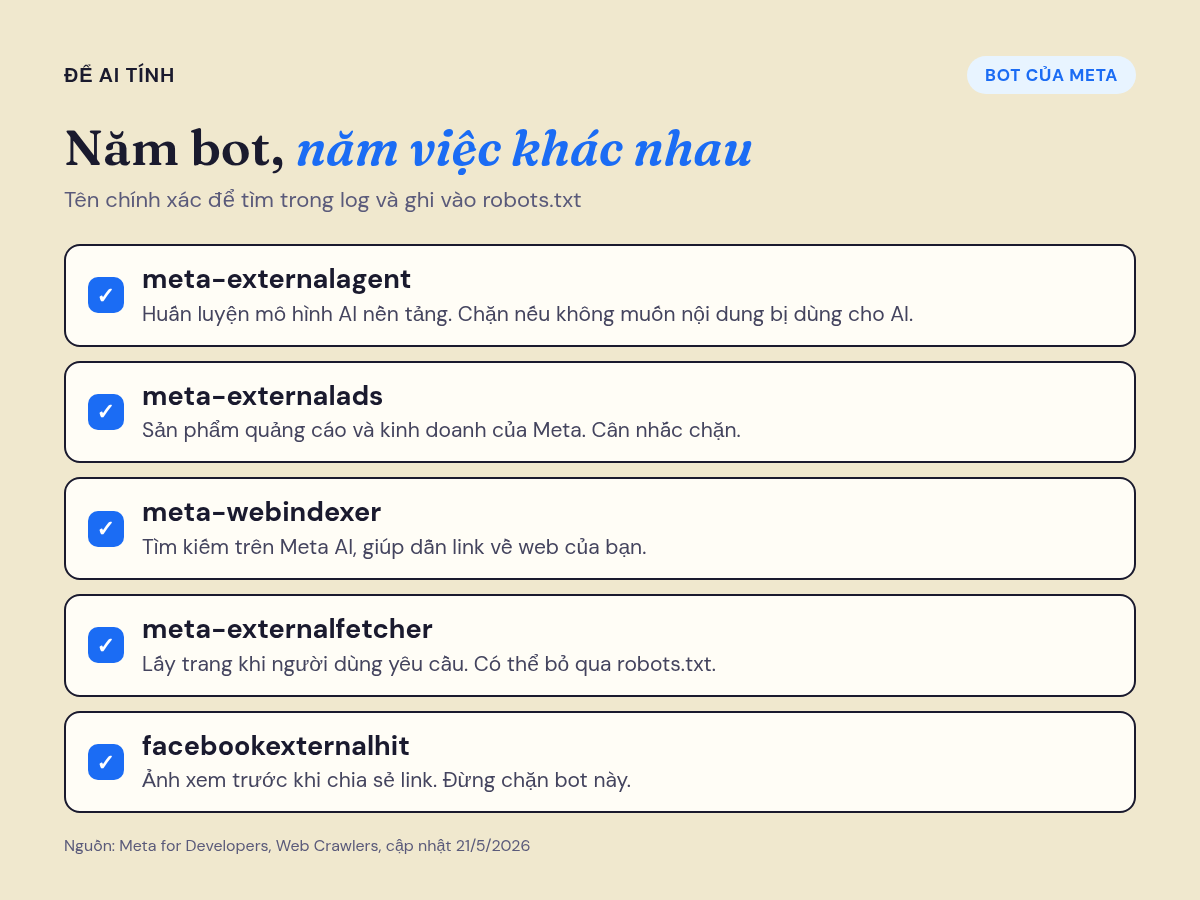
Một câu dễ nhớ: chặn meta-externalagent là chặn bot huấn luyện AI. Còn facebookexternalhit là bot làm ảnh xem trước link, chặn nó là tự làm khổ mình.
Làm sao biết bot Meta đã vào website của bạn?
Bạn không cần cài gì thêm. Có ba chỗ để xem.
Xem log truy cập trên hosting
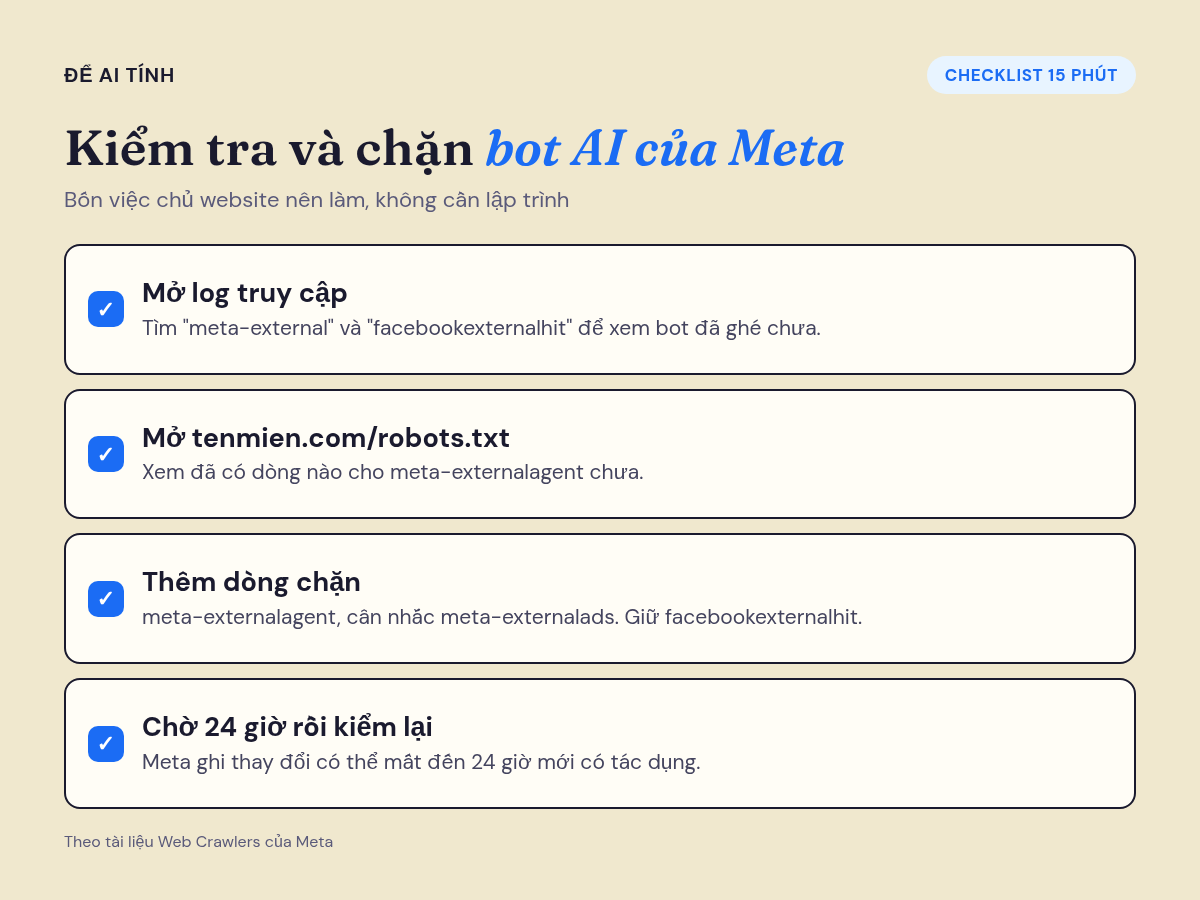
Hầu hết hosting có mục Access log hoặc Raw access trong trang quản trị. Tải file log về, mở bằng trình soạn thảo, rồi tìm từ “meta-external” và “facebookexternalhit”. Có dòng nào nghĩa là bot đó đã ghé, kèm thời gian và đường dẫn nó lấy.
Nếu bạn dùng máy chủ riêng, một lệnh là đủ:
grep -Ei "meta-external|meta-webindexer|facebookexternalhit" access.log
Lưu ý nhỏ: tên bot nằm trong chuỗi user agent, và ai cũng giả được chuỗi này. Nên log chỉ cho bạn biết “có thứ tự xưng là bot Meta”, không phải bằng chứng tuyệt đối.
Xem file robots.txt hiện tại
Gõ tên miền của bạn rồi thêm /robots.txt, ví dụ tenmien.com/robots.txt. Không thấy dòng nào nhắc đến meta-externalagent nghĩa là bạn đang cho bot huấn luyện AI của Meta vào tự do.
Xem thống kê bot của hosting hoặc CDN
Nếu web chạy qua một dịch vụ CDN hoặc tường lửa web có trang thống kê bot, hãy lọc theo tên bot Meta. Cách này nhìn được xu hướng theo ngày, dễ hơn đọc log thô.
Cách chặn Meta AI quét website bằng robots.txt
Mở file robots.txt (với WordPress, thường sửa được qua plugin SEO bạn đang dùng) và thêm:
User-agent: meta-externalagent
Disallow: /

User-agent: meta-externalads
Disallow: /
Hai bot này đúng là hai bot nằm trong ví dụ robots.txt của chính Meta. Vài điều nên biết:
- Giữ facebookexternalhit. Không chặn bot này để link chia sẻ vẫn có ảnh và tiêu đề đẹp.
- Cân nhắc meta-webindexer. Muốn Meta AI dẫn link về web bạn khi người dùng hỏi thì để nó vào.
- Chờ tối đa 24 giờ. Meta ghi rằng thay đổi robots.txt có thể mất đến 24 giờ mới có tác dụng do bộ nhớ đệm.
Tôi đã viết hướng dẫn từng bước kèm cách sửa trên WordPress ở bài chặn bot AI của Meta bằng robots.txt. Bài đó có bảng quyết định nên chặn bot nào tuỳ mục tiêu của bạn.
robots.txt có đủ để bảo vệ nội dung không?
Chưa đủ, nhưng là việc nên làm đầu tiên. Lý do:
- robots.txt là lời đề nghị, không phải hàng rào. Bot tử tế thì tuân theo. Meta tự ghi meta-externalfetcher và facebookexternalhit có thể bỏ qua robots.txt trong một số trường hợp.
- Điều khoản không nhắc robots.txt. Người phát ngôn của Meta nói với Nieman Lab rằng chủ nội dung vẫn dùng robots.txt để báo mong muốn. Nhưng theo Nieman Lab, chưa phiên bản điều khoản nào ghi điều này thành chữ.
- Điều khoản quảng cáo cũ đã cho phép thu thập. Search Engine Journal chỉ ra Điều khoản quảng cáo tự phục vụ hiện hành (ngày 22/8/2025) đã cho Meta thu thập trang web của bên quảng cáo cho mục đích bao gồm “nghiên cứu và huấn luyện”.
- Chặn hôm nay không xoá dữ liệu cũ. robots.txt chỉ có tác dụng cho các lần ghé sau.
Nội dung nào thật sự quý (bài trả phí, tài liệu nội bộ), hãy đặt sau đăng nhập. Đó mới là hàng rào thật.
Điều khoản thương mại mới của Meta nói gì?
Theo trang điều khoản chính thức, “mục đích kinh doanh” khá rộng: chạy quảng cáo, gửi tin nhắn marketing, bán hoặc đăng sản phẩm, có danh mục sản phẩm, quản lý Trang, quản lý Nhóm cho mục đích kinh doanh, dùng Ads Manager hay Meta Business Suite, hoặc đo lường. Nghĩa là chỉ quản lý một fanpage cho cửa hàng cũng đã nằm trong diện này.
Theo Ars Technica, bản điều khoản ban đầu cho phép Meta dùng phần mềm tự động truy cập website gắn với tài khoản doanh nghiệp, kể cả tạo tài khoản đăng nhập thử, và định kỳ lấy bản cập nhật. Sau lần sửa ngày 16/10, mục đích được ghi là cung cấp, phát triển, cải thiện, nghiên cứu và duy trì sản phẩm quảng cáo, kinh doanh, cùng mục đích an toàn và bảo mật.
Hiện điều khoản này chưa có hiệu lực. Meta đã hứa tham vấn và có thể lùi tiếp. Nhưng việc sửa robots.txt không phụ thuộc vào ngày nào cả. Làm một lần, dùng lâu dài.
Câu hỏi thường gặp
Chặn meta-externalagent có làm link chia sẻ lên Facebook mất ảnh không?
Không. Theo tài liệu của Meta, ảnh và tiêu đề xem trước do facebookexternalhit lấy. Bạn chặn meta-externalagent mà vẫn để facebookexternalhit thì link chia sẻ hiển thị bình thường.
Tôi chỉ có fanpage, không chạy quảng cáo, có liên quan không?
Có thể có. Trang điều khoản của Meta liệt kê cả việc quản lý Trang là mục đích kinh doanh. Dù điều khoản mới chưa áp dụng, bot meta-externalagent vẫn đi thu thập web như bình thường, nên robots.txt vẫn đáng sửa.
Sửa robots.txt bao lâu thì có tác dụng?
Meta ghi là có thể mất đến 24 giờ. Sau đó bạn mở lại log để xem bot còn lấy trang nào không. Có thắc mắc với bot của Meta, bạn liên hệ webmasters@meta.com.
Hoàng Nhật Mai – Founder hệ thống Để AI Tính
Nguồn
- Meta for Developers, “Meta Web Crawlers”, cập nhật 21/5/2026: https://developers.facebook.com/documentation/sharing/webmasters/web-crawlers
- Meta, Commercial Terms (bản cập nhật, hiệu lực dự kiến 20/11/2026): https://www.facebook.com/legal/commercial_terms
- Nieman Lab, “Meta pledges to consult publishers before finalizing its new terms”, 28/10/2026: https://www.niemanlab.org/2026/10/meta-pledges-to-consult-publishers-before-finalizing-its-new-terms/
- Reuters qua Investing.com, “Meta delays indefinitely its rollout of new commercial terms after publishers’ concerns”, 28/10/2026: https://www.investing.com/news/stock-market-news/meta-delays-indefinitely-its-rollout-of-new-commercial-terms-after-publishers-concerns-4980457
- The Verge, “Meta says it’ll probably delay its controversial new business terms again”, 28/10/2026: https://www.theverge.com/tech/1020769/meta-updated-business-terms-delay-indefinitely
- Reuters qua Investing.com, “Meta to delay new commercial terms criticised by publishers, advertisers”, 23/10/2026: https://www.investing.com/news/stock-market-news/meta-to-delay-new-commercial-terms-criticised-by-publishers-advertisers-4969745
- Ars Technica, “Meta drops the word ‘train’ from its commercial TOS after AI backlash”, 10/2026: https://arstechnica.com/tech-policy/2026/10/meta-drops-the-word-train-from-its-commercial-tos-after-ai-backlash/
- Search Engine Journal, “Meta’s New Terms Expand Crawling Rights Beyond Advertisers”, 10/2026: https://www.searchenginejournal.com/metas-new-terms-expand-crawling-rights-beyond-advertisers/593217/
- Genk, “Meta tự cấp quyền quét website khách hàng để dạy AI”, 10/2026: https://genk.vn/meta-tu-cap-quyen-quet-website-khach-hang-de-day-ai-165261019105625384.chn
Tư vấn, Trao đổi & Hợp tác
Bạn muốn ứng dụng AI vào công việc, đặt lịch coaching 1-1 hay hợp tác truyền thông? Hãy gửi thông tin cho tôi.
Công cụ AI liên quan
Tin liên quan
Chặn bot AI của Meta bằng robots.txt: 4 bước nên làm ngay
📅 28/10/2026
Higgsfield Genjutsu và Katana: làm lại video bằng nhân vật của bạn
📅 18/10/2026
Higgsfield Ads Studio: tạo ảnh quảng cáo từ website sản phẩm và chi phí credit thực tế
📅 18/10/2026