Chặn bot AI của Meta bằng robots.txt: việc nên làm trước 20/11
Nếu doanh nghiệp của bạn có Fanpage, tài khoản quảng cáo hay trang Instagram doanh nghiệp, thì chuyện này liên quan đến bạn, không chỉ đến các tòa soạn lớn.
Meta vừa lùi ngày áp dụng điều khoản thương mại mới từ 30/10 sang 20/11/2026. Tức là bạn còn khoảng ba tuần để quyết định: cho bot của Meta vào website đến đâu. Tin tốt là việc này không cần lập trình viên. Một file chữ tên robots.txt là đủ để bắt đầu.
Chuyện gì đang xảy ra với điều khoản của Meta
Theo Reuters ngày 23/10/2026, Meta gia hạn ngày hiệu lực của Commercial Terms và Self-Serve Ad Terms cập nhật sang 20/11, sau khi các nhà xuất bản và bên quảng cáo khiếu nại lên cơ quan cạnh tranh EU và Anh. Họ cho rằng điều khoản mới trao cho Meta quyền gần như không giới hạn với nội dung của họ cho dịch vụ AI. Meta bác bỏ cách hiểu này.
Nieman Lab cho biết điều khoản cho phép thu thập tự động nội dung từ các website “gắn với” tài khoản doanh nghiệp trên Facebook, Instagram, WhatsApp và Threads. Ngày 16/10, Meta đã bỏ chữ “train” (huấn luyện) và giới hạn mục đích ở “sản phẩm quảng cáo và kinh doanh”. Nhưng các chuyên gia pháp lý vẫn hoài nghi, và tính đến 23/10, không phiên bản nào của điều khoản ghi rõ Meta sẽ tôn trọng robots.txt.
Phát ngôn viên Meta nói với Nieman Lab rằng thời gian gia hạn là để giải thích “cách Meta dùng web crawler và việc chủ nội dung vẫn có thể dùng robots.txt để thể hiện mong muốn”.
Phía báo chí không mấy hài lòng. Hiệp hội Báo chí Thế giới WAN-IFRA đã gửi thư ngày 22/10 yêu cầu đưa robots.txt thành cam kết ràng buộc trong điều khoản. Sau khi Meta lùi hạn, CEO Stig Ørskov nói đây là “một bước đáng hoan nghênh, nhưng không giải quyết được mối lo của chúng tôi” (tôi dịch).
Tóm lại: robots.txt là công cụ Meta nói sẽ tôn trọng, nhưng chưa phải cam kết trên giấy. Làm vẫn hơn không, nhưng đừng coi nó là áo giáp.
Meta có những bot nào? Danh sách từ tài liệu chính thức
Đây là danh sách lấy từ trang Meta Web Crawlers dành cho nhà phát triển của Meta. Tôi chỉ ghi những bot có trong tài liệu này, không đoán thêm.
| Tên bot (user-agent) | Meta mô tả dùng để làm gì | Có tuân theo robots.txt? |
|---|---|---|
meta-externalagent |
Thu thập web cho các mục đích như huấn luyện mô hình AI nền tảng hoặc cải thiện sản phẩm bằng cách lập chỉ mục nội dung | Có |
meta-externalads |
Cải thiện quảng cáo và các sản phẩm, dịch vụ kinh doanh | Có |
meta-webindexer |
Cải thiện chất lượng kết quả tìm kiếm của Meta AI. Meta nói cho phép bot này giúp họ trích dẫn và dẫn link về nội dung của bạn | Có |
facebookexternalhit |
Lấy tiêu đề, mô tả, ảnh thumbnail khi ai đó chia sẻ link lên Facebook | Có thể bỏ qua khi kiểm tra bảo mật, mã độc |
meta-externalfetcher |
Lấy từng link theo yêu cầu của người dùng, kể cả cho tác vụ AI agent | Có thể bỏ qua robots.txt |
Hai điều tôi rút ra từ bảng này:
- Đừng chặn
facebookexternalhitnếu bạn còn muốn link chia sẻ lên Facebook hiện ảnh và tiêu đề đẹp. Chặn nó là tự bắn vào chân Fanpage của mình. - Meta chưa nói rõ bot nào sẽ phục vụ điều khoản thương mại mới. Theo mô tả,
meta-externaladscó mục đích gần nhất. Đây là suy luận của tôi từ tài liệu, không phải Meta xác nhận.
Hướng dẫn chặn bot AI của Meta bằng robots.txt
Bước 1: Xem robots.txt hiện tại của bạn
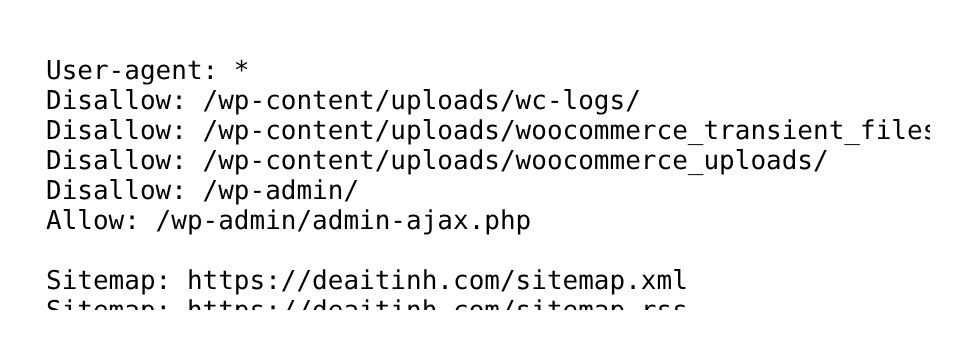
Mở trình duyệt, gõ tenmiencuaban.com/robots.txt. Ví dụ robots.txt của chính deaitinh.com hiện chỉ có các dòng chung cho mọi bot (User-agent: *), chưa có dòng nào riêng cho Meta. Nếu của bạn cũng vậy, nghĩa là các bot ở trên đang được vào như mọi bot khác.
Bước 2: Quyết định chặn bot nào
Đây là quyết định kinh doanh, không phải kỹ thuật. Gợi ý của tôi:
- Muốn hạn chế nội dung bị dùng huấn luyện AI: chặn
meta-externalagent. - Lo nội dung bị dùng cho sản phẩm quảng cáo, kinh doanh của Meta: cân nhắc chặn
meta-externalads. Tôi chưa thấy tài liệu nào nói chặn bot này có ảnh hưởng đến việc chạy quảng cáo của bạn hay không, nên hãy theo dõi sau khi chặn. - Muốn được Meta AI trích dẫn, dẫn link: để yên
meta-webindexer. - Giữ nguyên
facebookexternalhit.
Bước 3: Thêm dòng vào robots.txt
Ví dụ chặn bot huấn luyện AI và bot quảng cáo, vẫn cho bot tìm kiếm Meta AI và bot xem trước link:
User-agent: meta-externalagent
Disallow: /

User-agent: meta-externalads
Disallow: /
Nếu chỉ muốn chặn một thư mục, ví dụ /tai-lieu/, thì thay Disallow: / bằng Disallow: /tai-lieu/. Cú pháp này theo đúng ví dụ trong tài liệu của Meta.
Với WordPress, bạn có thể sửa robots.txt trong plugin SEO đang dùng (Yoast, Rank Math đều có mục sửa file này), hoặc nhờ người quản trị hosting sửa file ở thư mục gốc. Giữ nguyên các dòng cũ như Sitemap:, chỉ thêm khối mới.
Bước 4: Kiểm tra lại
- Mở lại
tenmiencuaban.com/robots.txt, xem các dòng mới đã hiện chưa. - Meta lưu bộ nhớ đệm robots.txt tối đa 24 giờ, nên hôm sau bot mới “đọc” thay đổi.
- Nếu có quyền xem log máy chủ, tìm các chuỗi
meta-externalagent/1.1hoặcmeta-externalads/1.1để xem bot còn ghé không.
Những gì robots.txt không làm được
Nói thẳng để bạn khỏi ảo tưởng:
- robots.txt là lời đề nghị, không phải hàng rào. Bot tử tế thì nghe, bot không tử tế thì không.
- Nó không xóa nội dung đã bị thu thập trước đó.
- Hai bot
meta-externalfetchervàfacebookexternalhitđược Meta ghi rõ là có thể bỏ qua robots.txt trong một số trường hợp. - Điều khoản mới chưa ghi cam kết tôn trọng robots.txt. Nếu nội dung là tài sản cốt lõi, hãy hỏi luật sư về điều khoản bạn đã đồng ý khi dùng công cụ doanh nghiệp của Meta.
Điều tôi muốn bạn làm trong tuần này
Dành 15 phút: mở robots.txt, quyết định bot nào được vào, thêm vài dòng, kiểm tra lại. Ghi ngày đã sửa vào sổ tay vận hành của team. Đến 20/11, nếu Meta đổi chữ trong điều khoản hay thêm bot mới, bạn chỉ cần sửa tiếp chứ không phải bắt đầu từ đầu.
Nội dung là tài sản. Tài sản thì phải có khóa cửa, kể cả khi ổ khóa chưa xịn lắm.
Hoàng Nhật Mai – Founder hệ thống Để AI Tính
Câu hỏi thường gặp
Chặn meta-externalagent có làm link chia sẻ lên Facebook mất ảnh không?
Không. Ảnh, tiêu đề khi chia sẻ link do bot facebookexternalhit lấy. Chỉ cần đừng chặn facebookexternalhit.
Sửa robots.txt bao lâu thì Meta nhận?
Theo tài liệu của Meta, bot có thể lưu bộ nhớ đệm robots.txt tối đa 24 giờ, nên thay đổi có thể mất đến một ngày mới có hiệu lực.
robots.txt có bảo vệ nội dung hoàn toàn không?
Không. robots.txt là lời đề nghị, không xóa nội dung đã bị thu thập. Meta cũng ghi rõ meta-externalfetcher và facebookexternalhit có thể bỏ qua robots.txt trong một số trường hợp.
Nguồn tham khảo
- Meta for Developers, “Meta Web Crawlers”: https://developers.facebook.com/docs/sharing/webmasters/web-crawlers
- Reuters (qua Investing.com), “Meta to delay new commercial terms criticised by publishers, advertisers”, 23/10/2026: https://www.investing.com/news/stock-market-news/meta-to-delay-new-commercial-terms-criticised-by-publishers-advertisers-4969745
- Nieman Lab, “Meta delays rollout of terms that would allow broad scraping of news sites. Legal experts are still skeptical.”, 10/2026: https://www.niemanlab.org/2026/10/meta-delays-rollout-of-terms-that-would-allow-broad-scraping-of-news-sites-legal-experts-are-still-skeptical/
- WAN-IFRA, thư gửi Meta ngày 22/10/2026 và phần bổ sung 23/10/2026: https://wan-ifra.org/2026/10/worlds-news-publishers-call-on-meta-to-halt-scraping-clause-in-new-commercial-terms/
- Tạp Chí Số, “Meta hoãn điều khoản nội dung AI đến 20/11 vì sức ép từ nhà xuất bản”, 24/10/2026: https://tapchiso.com/meta-hoan-dieu-khoan-noi-dung-ai-den-20-11-vi-suc-ep-tu-nha-xuat-ban/
Tư vấn, Trao đổi & Hợp tác
Bạn muốn ứng dụng AI vào công việc, đặt lịch coaching 1-1 hay hợp tác truyền thông? Hãy gửi thông tin cho tôi.
Công cụ AI liên quan
Tin liên quan
Higgsfield Genjutsu và Katana: làm lại video bằng nhân vật của bạn
📅 18/10/2026
Higgsfield Ads Studio: tạo ảnh quảng cáo từ website sản phẩm và chi phí credit thực tế
📅 18/10/2026
Ứng dụng Higgsfield trong ngành thời trang: từ ảnh mẫu thô đến lookbook chuyên nghiệp
📅 16/10/2026