Claude tự viết một dòng đánh giá sau mỗi câu trả lời: chuyện gì đang xảy ra với cuộc chat của bạn
Mấy hôm nay trên X lan truyền chuyện “Claude chấm điểm người dùng sau mỗi câu trả lời”, và lần này có tài liệu thật. Anthropic gọi đó là self-assessment, tức tự đánh giá: sau mỗi câu trả lời, Claude nhận thêm một lệnh ẩn và viết một bản đánh giá an toàn ngắn về cuộc chat. Bản đánh giá không chặn gì, chỉ đưa vào rà soát sau. Hiểu đúng cơ chế thì đỡ hoang mang, và cũng biết mình nên cẩn thận ở đâu.
Cơ chế chạy thế nào
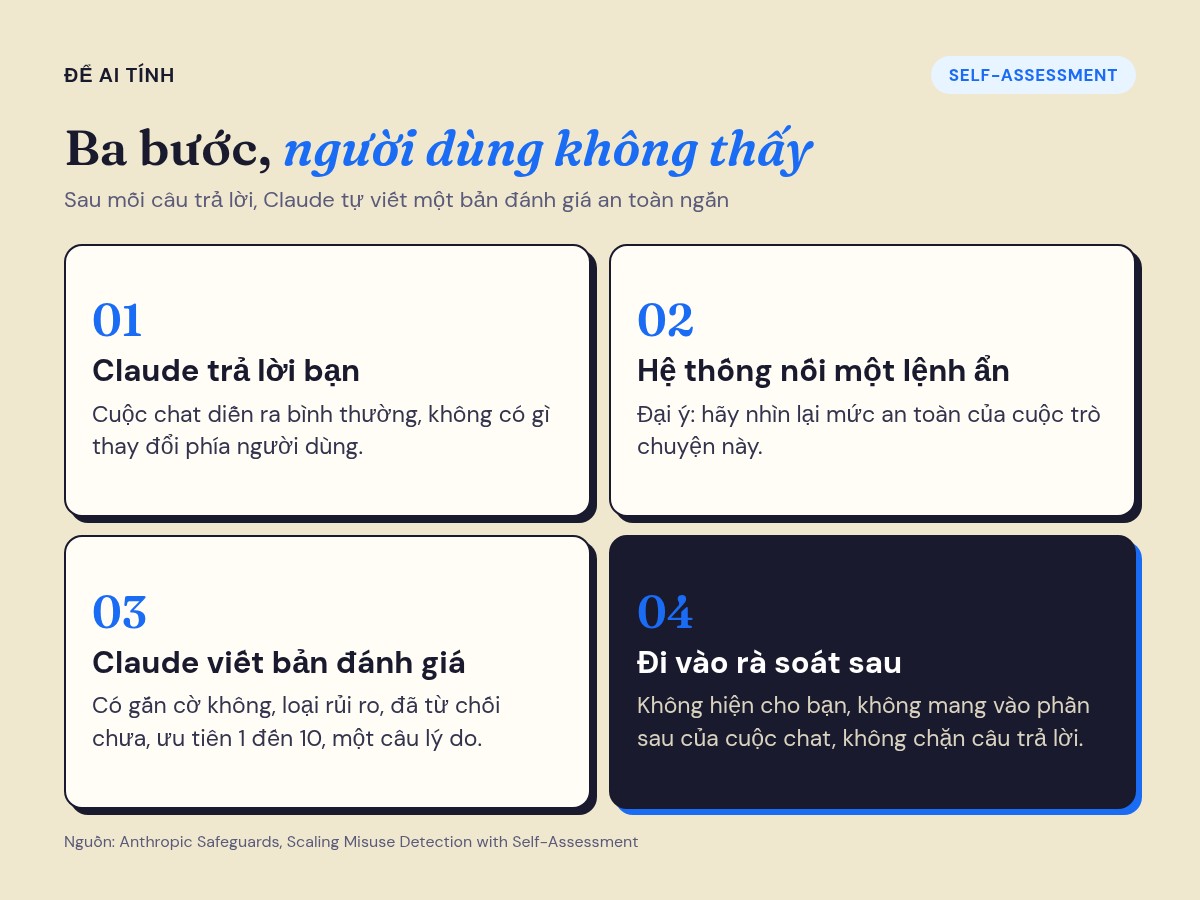
Theo bài nghiên cứu của nhóm Safeguards của Anthropic đề ngày 16/10/2026, sau mỗi lượt Claude trả lời, hệ thống nối thêm một chỉ dẫn ngắn, đại ý “hãy nhìn lại mức an toàn của cuộc trò chuyện này”. Claude trả lời bằng một bản đánh giá theo khuôn cố định.
Cuộc chat bình thường thì bản đánh giá chỉ là “không gắn cờ”. Nếu thấy đáng ngờ, Claude ghi thêm loại rủi ro, nhóm chính sách con, mình đã từ chối hay chưa, mức ưu tiên từ 1 đến 10 cho người duyệt, và một câu lý do.
Ai thấy dòng đánh giá này
Người dùng không thấy. Anthropic ghi rõ hai lượt cuối này không hiện cho người dùng và không được mang vào phần còn lại của cuộc chat. Nói cách khác, nó không làm Claude trả lời bạn khác đi ở câu sau.
Vì sao Anthropic làm vậy
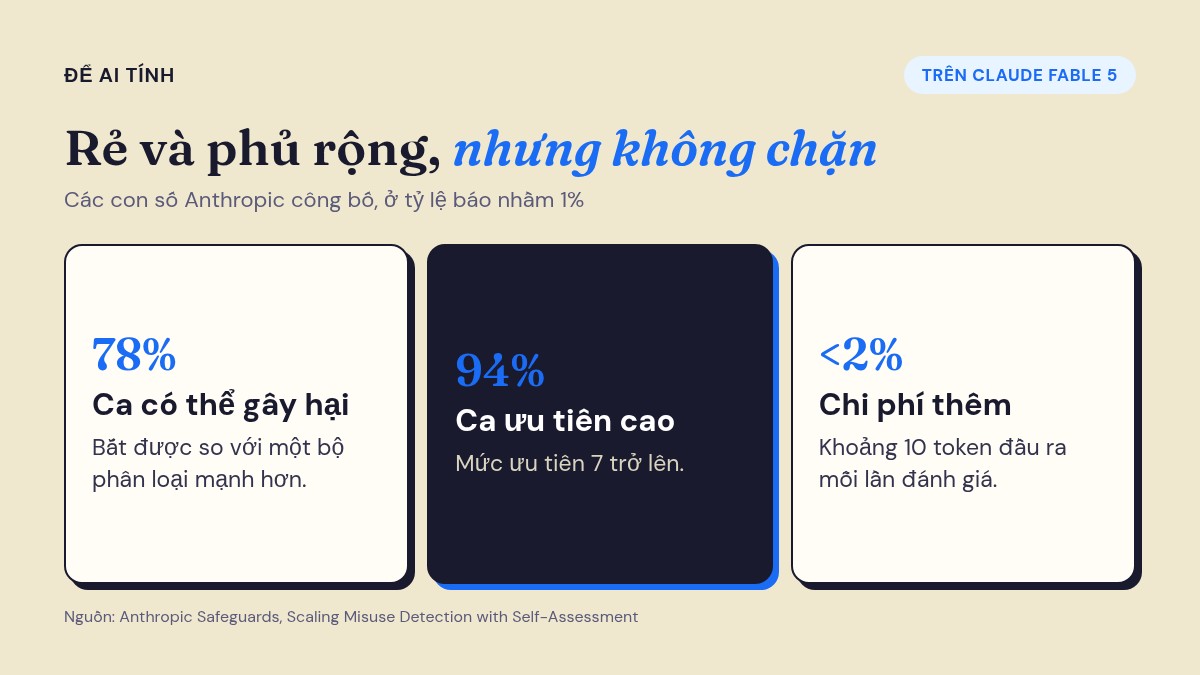
Lý do chính là chi phí. Cuộc chat đã nằm sẵn trong bộ nhớ đệm của mô hình, nên mỗi lần đánh giá chỉ tốn trung bình khoảng 10 token đầu ra. Anthropic ước tính cách này cộng thêm dưới 2% chi phí tính toán, và không tính khoản này vào hoá đơn khách hàng.
Những con số đáng chú ý
Trên Claude Fable 5, với tỷ lệ báo nhầm 1%, self-assessment bắt được 78% số cuộc chat mà một bộ phân loại mạnh hơn coi là có thể gây hại, và 94% số ca ưu tiên cao (mức 7 trở lên). Kỹ thuật này chạy thụ động trên lưu lượng thật từ tháng 6.
Anthropic cũng tự nói điểm yếu: dùng làm bộ chặn trực tiếp thì nó yếu. Trong thử nghiệm tấn công 24 bài an ninh mạng, tỷ lệ tấn công thành công chỉ giảm từ 79% xuống 54% khi dùng nó để chặn. Vì thế nó chỉ là một lớp rà soát sau, chạy cạnh các lớp chặn khác.
Có bị khoá tài khoản vì một dòng đánh giá không
Không phải theo kiểu một cờ là khoá. Anthropic viết rằng một bản đánh giá chỉ là tín hiệu để xem xét thêm, không phải kết luận người dùng vi phạm. Ở một số nhóm rủi ro, cờ được gộp theo tổ chức mỗi đêm, tổ chức nào có nhiều cờ ưu tiên cao mới được chuyển cho đội thực thi xem bằng người. Các nhóm này gồm vũ khí, cực đoan bạo lực, thao túng thông tin, bầu cử, lừa đảo và lạm dụng trẻ em.
Quyền riêng tư
Anthropic nói self-assessment không thu thêm dữ liệu, chỉ đọc cuộc chat Claude vừa xử lý, và không chạy với khách hàng có thoả thuận không lưu dữ liệu (zero-data-retention). Câu lý do là văn bản tự do có thể diễn giải lại nội dung chat, nên được quản lý như chính nội dung chat.
Cùng tuần, OpenAI công bố ChatGPT sẽ tự kết thúc cuộc chat khi người dùng có dấu hiệu ám ảnh bạo lực, ai bị ngắt nhiều lần có thể bị tạm dừng tài khoản. Hai hãng, cùng một hướng: AI không chỉ trả lời, nó còn để ý.
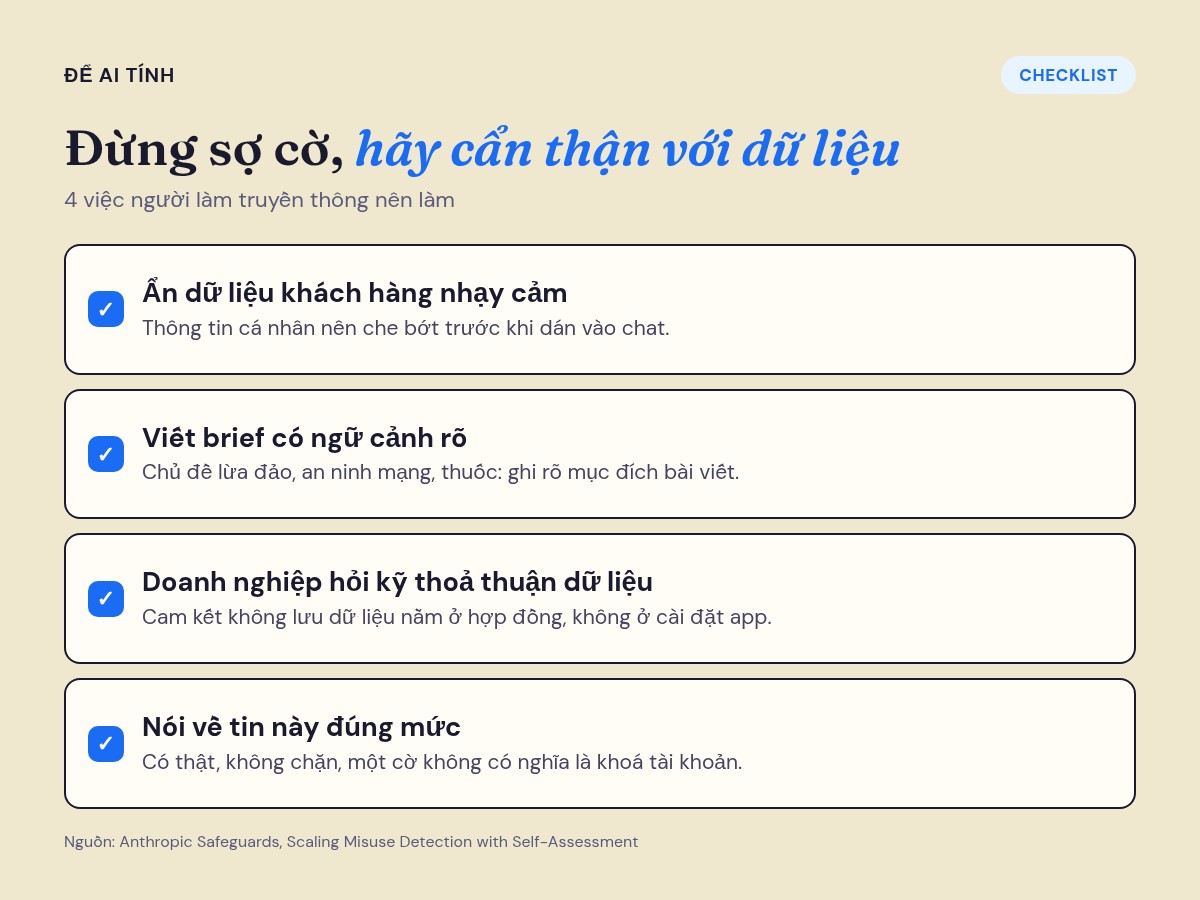
Người làm truyền thông nên làm gì
1. Đừng đưa dữ liệu khách hàng nhạy cảm vào chat thường. Dữ liệu đã vào cuộc chat thì chịu chính sách lưu trữ của gói bạn dùng. Thông tin cá nhân của khách nên ẩn bớt trước khi dán.
2. Viết brief có ngữ cảnh rõ. Nội dung về an ninh mạng, thuốc, vũ khí hay lừa đảo dễ bị hiểu nhầm. Ghi rõ mục đích, ví dụ “bài cảnh báo người dùng về chiêu lừa”, vừa giúp câu trả lời tốt hơn vừa đỡ mơ hồ.
3. Doanh nghiệp hỏi kỹ về gói và thoả thuận dữ liệu. Nếu công ty cần cam kết không lưu dữ liệu, đó là chuyện của hợp đồng, không phải của cài đặt trong app.
4. Khi làm nội dung về tin này, nói đúng mức. Có thật, không chặn, không ai đọc từng dòng của bạn chỉ vì một cờ. Câu “Claude chấm điểm rồi khoá nick” là phóng đại.
Câu hỏi thường gặp
Claude có đọc lại và nhớ đánh giá của nó về tôi không?
Theo Anthropic, bản đánh giá không được mang vào phần sau của cuộc chat, nên không ảnh hưởng câu trả lời tiếp theo.
Tắt tính năng này được không?
Anthropic không nói đến tuỳ chọn tắt cho người dùng. Tài liệu chỉ nêu nó không chạy với lưu lượng thuộc thoả thuận không lưu dữ liệu.
Một cờ có làm tôi bị khoá tài khoản ngay không?
Không. Anthropic ghi một bản đánh giá chỉ là tín hiệu để xem xét thêm. Việc xử lý dựa vào mức ưu tiên, cờ lặp lại và người duyệt.
Hoàng Nhật Mai – Founder hệ thống Để AI Tính
Nguồn tham khảo
- Anthropic Safeguards, Scaling Misuse Detection with Self-Assessment (16/10/2026): https://safeguards.anthropic.com/2026/self-assessment/
- OpenAI, Community safety report and new protections for teens (30/10/2026): https://openai.com/index/community-safety-report-and-new-protections-for-teens/
Tư vấn, Trao đổi & Hợp tác
Bạn muốn ứng dụng AI vào công việc, đặt lịch coaching 1-1 hay hợp tác truyền thông? Hãy gửi thông tin cho tôi.
Công cụ AI liên quan
Tin liên quan
Pika H3 Flex lên app: video AI nhận 12 file tham chiếu, tách 5 lớp âm thanh, xuất tới 4K
📅 02/11/2026
Từ tháng 12, ChatGPT không đếm tin nhắn nữa mà đếm token: gói Plus, Pro, Business đổi gì
📅 02/11/2026
Gemini trong Google Slides giờ sửa cả bộ slide một lần, không phải từng trang
📅 01/11/2026