Genspark AI Audio: tạo giọng đọc tiếng Việt và tiếng động chỉ 23 credit
Âm thanh chân thực gồm lời thuyết minh truyền cảm và hiệu ứng tiếng động môi trường sống động là yếu tố then chốt tạo nên sức hấp dẫn cho các video ngắn. Tính năng AI Audio trong Genspark AI Workspace 6.0 tích hợp 13 mô hình giọng đọc và âm thanh đa dạng. Tuy nhiên, việc thư viện chưa hỗ trợ lọc riêng tiếng Việt đòi hỏi người dùng phải nắm vững kỹ thuật mô tả giọng bằng lời văn để không bị lãng phí credit.
Trả lời nhanh: Genspark AI Audio tích hợp 13 mô hình âm thanh nhưng thư viện mẫu chỉ có tiếng Anh, Trung, Nhật, Hàn mà chưa có tiếng Việt, buộc người dùng phải mô tả giọng bằng lời. Thử nghiệm thực tế tạo câu chào 5,04 giây và đoạn tiếng động 8 giây chỉ tiêu tốn tổng cộng 23 credit từ tài khoản Plus.
Hệ thống 13 mô hình trong Genspark AI Audio và hệ số credit
Khác với các công cụ đọc văn bản thông thường, AI Audio của Genspark phân định các mô hình xử lý giọng nói và hiệu ứng âm thanh theo từng bậc hệ số nhân credit rõ ràng:
| Mô hình âm thanh | Hệ số credit | Lĩnh vực thế mạnh | Đánh giá chi phí |
|---|---|---|---|
| Fish Audio TTS | 0,16× | Đọc văn bản nhanh, giọng đọc tin tức | Rất rẻ, phù hợp đọc đoạn dài |
| Gemini 3.8 Flash TTS | 0,27× | Ngữ điệu tự nhiên, đa ngôn ngữ | Kinh tế, phát âm chuẩn xác |
| ElevenLabs V4 TTS | 1× | Chuẩn phòng thu, giàu cảm xúc | Chi phí tiêu chuẩn cao cấp |
| MiniMax Voice Clone | 10× | Nhân bản giọng nói chuyên sâu | Đắt nhất, chỉ dùng khi cần bản sao giọng |
| Các mô hình tiếng động | Hệ số tùy chọn | Tạo hiệu ứng âm thanh môi trường (SFX) | Tính credit theo giây thực tế |
Số liệu đo ngày 14–15/10/2026 trên gói Plus, giá và credit có thể đổi.
Thử nghiệm thực tế: tạo câu chào 5,04 giây và tiếng động 8 giây
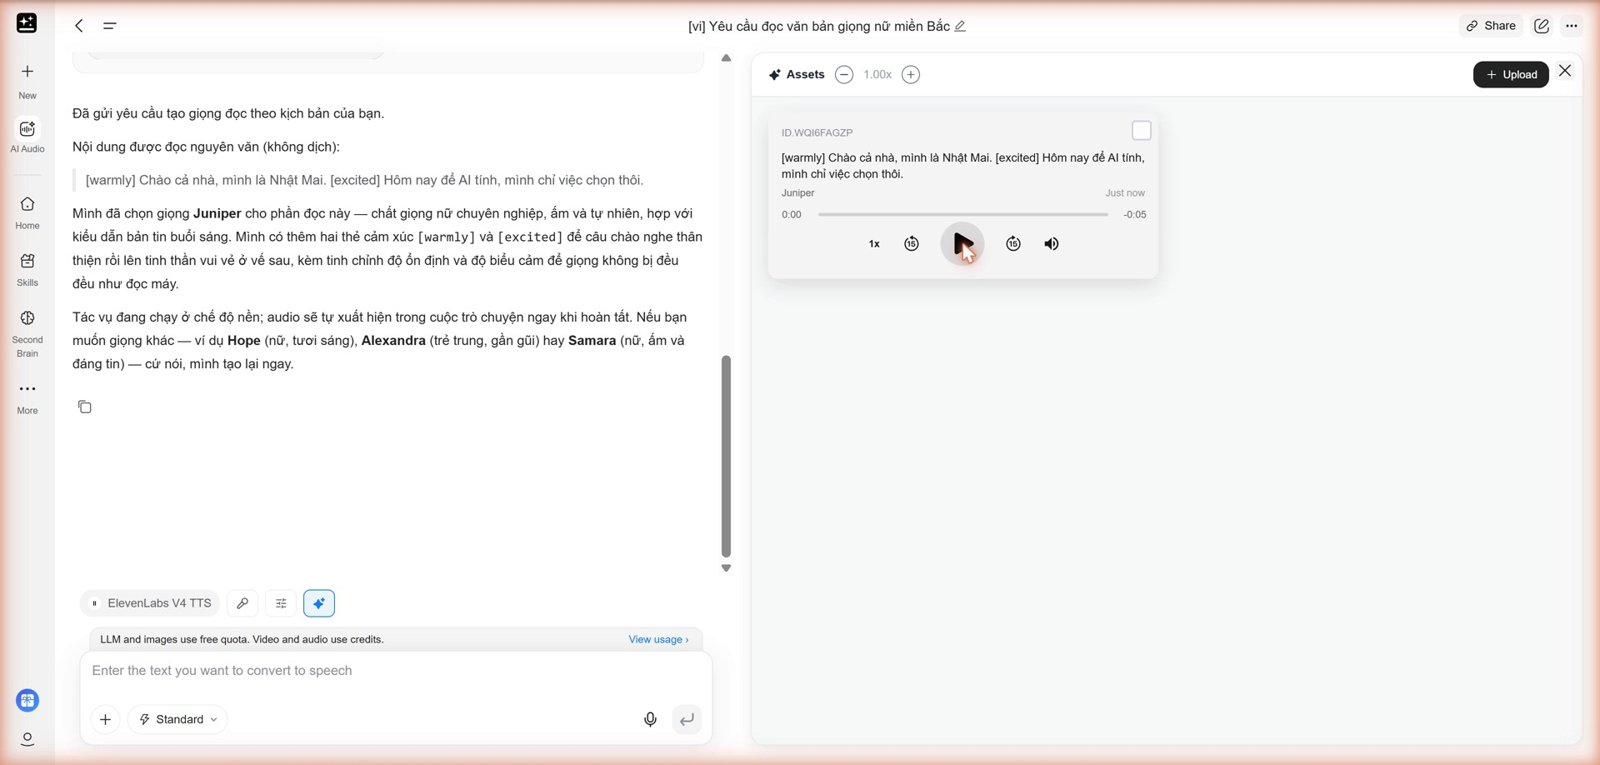
Trong đợt kiểm thử ngày 14/10/2026, tôi thực hiện hai tác vụ âm thanh nhỏ phục vụ video ngắn: một câu chào mở đầu bằng tiếng Việt dài 5,04 giây và một đoạn hiệu ứng tiếng động môi trường dài 8 giây (tiếng bước chân nhẹ trên sàn gỗ và tiếng lật trang sách).
Khi mở thư viện giọng mẫu có sẵn, hệ thống chỉ hỗ trợ lọc theo 4 ngôn ngữ: tiếng Anh, tiếng Trung, tiếng Nhật và tiếng Hàn, hoàn toàn vắng bóng danh mục tiếng Việt. Để vượt qua rào cản này, tôi áp dụng phương pháp mô tả chi tiết đặc điểm giọng bằng văn bản trong câu lệnh: yêu cầu giọng nữ miền Bắc thanh lịch, tốc độ vừa phải, âm vực ấm áp và rõ dấu tiếng Việt.
Kết quả nhận được rất thuyết phục: câu chào 5,04 giây được đọc trôi chảy, tròn vành rõ chữ và không có cảm giác thô cứng. Đoạn tiếng động 8 giây có độ vang tự nhiên, chân thực. Khi kiểm tra trang Credit Usage, toàn bộ cả hai tác vụ chỉ khấu trừ tổng cộng đúng 23 credit từ tài khoản Plus. Đây là mức chi phí rất tiết kiệm cho việc hoàn thiện phần âm thanh video.
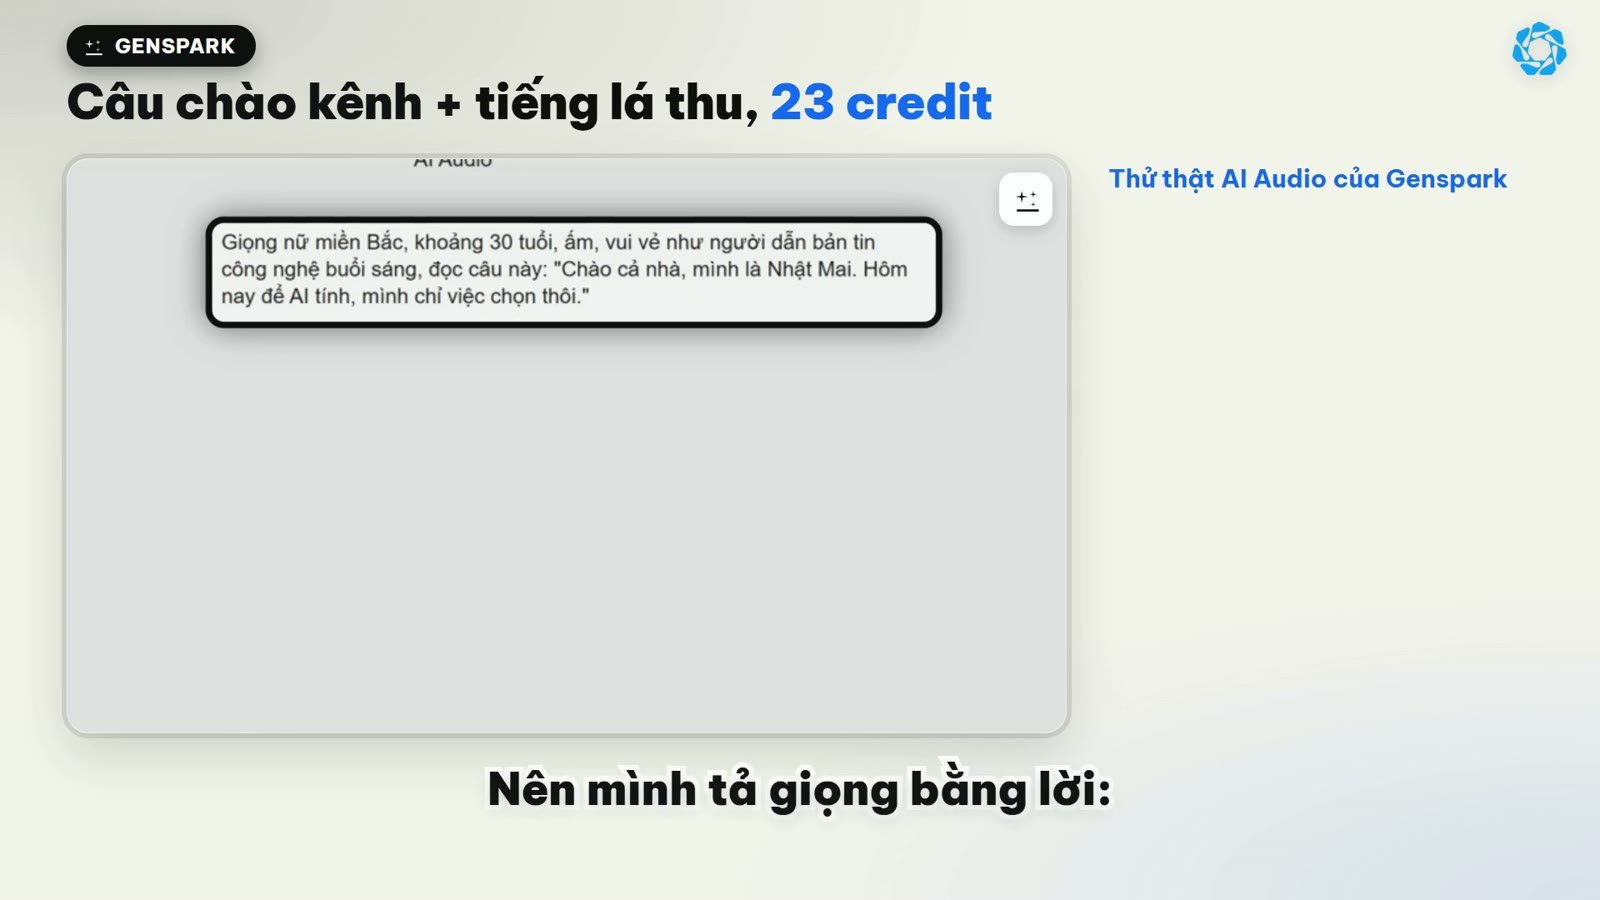
Kỹ thuật mô tả giọng đọc bằng lời văn khi thiếu danh mục mẫu
Để đạt được giọng đọc tiếng Việt ưng ý trên các mô hình TTS quốc tế, bạn cần tuân thủ 3 nguyên tắc mô tả sau:
- Xác định rõ vùng miền và âm sắc: Ghi rõ “Northern Vietnamese accent” (giọng miền Bắc) hoặc “Southern Vietnamese accent” (giọng miền Nam), kèm theo các tính từ mô tả âm vực như “warm and clear” (ấm áp và rõ ràng).
- Kiểm soát tốc độ đọc: Chỉ định rõ nhịp điệu đọc bình thản, có khoảng ngắt nghỉ 0,5 giây sau các dấu chấm câu để người nghe dễ tiếp thu thông tin.
- Hướng dẫn cảm xúc: Mô tả thái độ của người nói, ví dụ như “friendly and professional” (thân thiện và chuyên nghiệp) để AI điều chỉnh ngữ điệu phù hợp với tính chất của video.
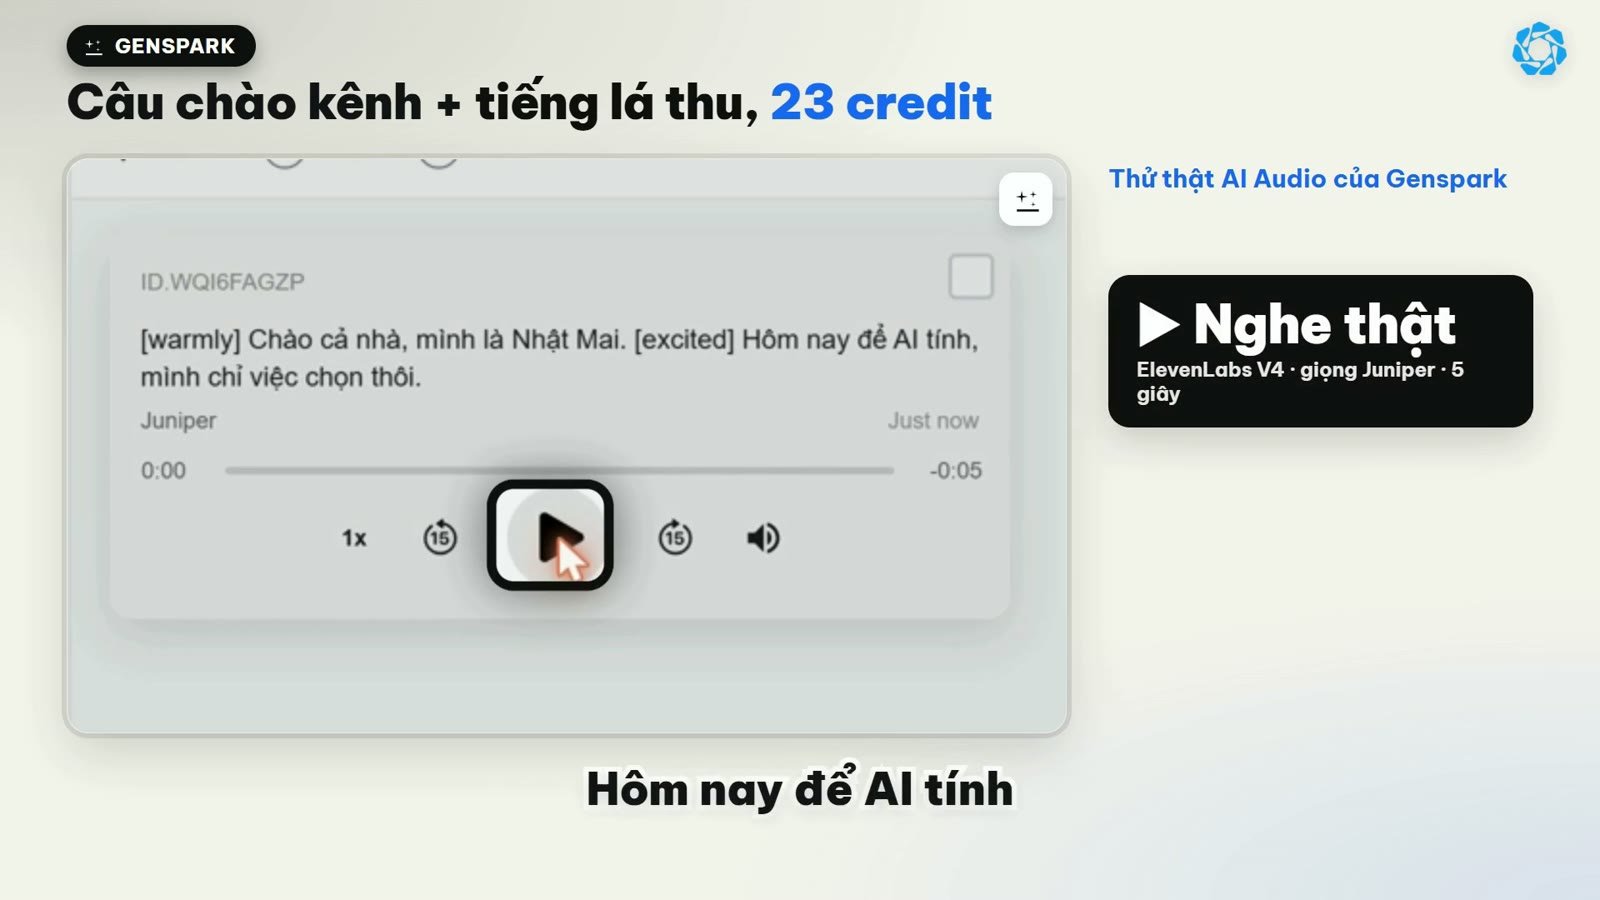
Khuôn mẫu prompt tạo giọng đọc và hiệu ứng âm thanh
Bạn có thể áp dụng mẫu câu lệnh có cấu trúc dưới đây để tạo âm thanh cho kênh:
Kích hoạt tính năng: AI Audio.
Loại tác vụ: [Tạo giọng đọc thuyết minh (TTS) / Tạo hiệu ứng tiếng động (SFX)].
Yêu cầu âm thanh:
- Ngôn ngữ thể hiện: Tiếng Việt chuẩn.
- Đặc điểm giọng: [Giọng nam / nữ], vùng miền [miền Bắc / miền Nam], phong cách [thân thiện / trang trọng / năng động].
- Tốc độ đọc: Vừa phải, ngắt nghỉ rõ ràng sau các dấu câu.
Nội dung văn bản đọc:
"[Dán đoạn văn bản cần đọc vào đây]"
Ví dụ mẫu đã điền sẵn cho một câu chào mở đầu video công nghệ:
Kích hoạt tính năng: AI Audio.
Loại tác vụ: Tạo giọng đọc thuyết minh (TTS).
Yêu cầu âm thanh:
- Ngôn ngữ thể hiện: Tiếng Việt chuẩn.
- Đặc điểm giọng: Giọng nữ miền Bắc thanh lịch, âm vực ấm áp, phong cách chuyên gia công nghệ thân thiện.
- Tốc độ đọc: Vừa phải, truyền cảm, tròn vành rõ chữ.
Nội dung văn bản đọc:
"Chào bạn, chào mừng bạn quay trở lại với chuỗi video chia sẻ giải pháp làm việc thông minh của Để AI Tính."
Bốn trường hợp ứng dụng thực tế của AI Audio
Người dựng video ngắn: Tạo nhanh các câu bình luận mở đầu và hiệu ứng tiếng động vui nhộn cho video TikTok mà không cần micro thu âm đắt tiền.
Nhà sản xuất sách nói: Sử dụng các mô hình hệ số thấp như Fish Audio (0,16×) để chuyển đổi các chương sách dài thành tệp âm thanh nghe thử.
Doanh nghiệp làm tổng đài tự động: Soạn thảo các thông điệp lời chào điện thoại khách hàng với chi phí chỉ vài chục credit.
Lập trình viên phát triển ứng dụng di động: Tạo các âm thanh thông báo ngắn cho các tính năng trong phần mềm mới.
Dùng thử: Khi đã có tệp âm thanh câu chào 23 credit sắc nét, bạn có thể đưa giọng đọc này vào để avatar ảo chuyển động môi khớp từng từ tại trang nền tảng avatar HeyGen chính thức với chất lượng hình ảnh Full HD.
Câu hỏi thường gặp
Tạo giọng đọc và tiếng động trên Genspark tốn bao nhiêu credit?
Thử nghiệm ngày 14/10/2026 cho thấy việc tạo câu chào 5,04 giây và đoạn tiếng động 8 giây chỉ tốn tổng cộng đúng 23 credit từ tài khoản Plus.
Tại sao thư viện mẫu của AI Audio không có tiếng Việt?
Giao diện hiện mới chỉ hỗ trợ lọc mẫu cho tiếng Anh, Trung, Nhật và Hàn. Người dùng cần mô tả đặc tính giọng tiếng Việt bằng câu lệnh để hệ thống tổng hợp.
Mô hình AI Audio nào có chi phí rẻ nhất?
Mô hình Fish Audio TTS có hệ số tiết kiệm nhất là 0,16×, tiếp theo là Gemini 3.8 Flash TTS với hệ số 0,27×.
Có thể tạo hiệu ứng tiếng động môi trường trên Genspark không?
Có. Tính năng SFX cho phép bạn mô tả bất kỳ âm thanh đời sống nào (tiếng mưa rơi, tiếng gõ bàn phím, tiếng bước chân) để AI sinh ra tệp âm thanh riêng.
Âm thanh tạo từ AI Audio có được dùng Free Quota không?
Không. Quy định của Genspark là mọi tác vụ âm thanh và video đều bị khấu trừ credit trực tiếp vào tài khoản Plus.
Bài tham khảo trên Để AI Tính
- https://deaitinh.com/so-sanh-synthesys-io-vs-elevenlabs-giai-phap-long-tieng-ai-tieng-viet/
- https://deaitinh.com/thiet-ke-giong-ai-heygen/
Công cụ nhắc trong bài
- GensparkDùng thử Xem đánh giá
- GeminiDùng thử Xem đánh giá
- HeyGenDùng thử Xem đánh giá
Liên kết dùng thử là liên kết giới thiệu: bạn không trả thêm phí, tôi nhận hoa hồng nhỏ để duy trì nội dung miễn phí.
Hoàng Nhật Mai – Founder hệ thống Để AI Tính
Hệ sinh thái Để AI Tính
- Thư viện công cụ AI chọn lọc: deaitinh.com/thu-vien-tool
- TikTok: /deaitinh · Fanpage: /deaitinh · YouTube: /@Đểaitính
- Khoá học và tài liệu AI: www.deaitinh.com
Tư vấn, Trao đổi & Hợp tác
Bạn muốn ứng dụng AI vào công việc, đặt lịch coaching 1-1 hay hợp tác truyền thông? Hãy gửi thông tin cho tôi.
Công cụ AI liên quan
Tin liên quan
Đánh giá Higgsfield AI năm 2026: trạm làm phim đa mô hình có thực sự thay thế 7 công cụ lẻ?
📅 16/11/2026
Bria AI là gì? Đánh giá công cụ làm ảnh sản phẩm sạch bản quyền
📅 13/11/2026
Glide là gì? Cách biến Google Sheets thành ứng dụng quản lý nội bộ
📅 13/11/2026