Claude Fable 5.1: AI chuyên môn đi cùng lớp bảo vệ
Tác giả: Hoàng Nhật Mai – Để AI Tính · Cập nhật: 15/09/2026
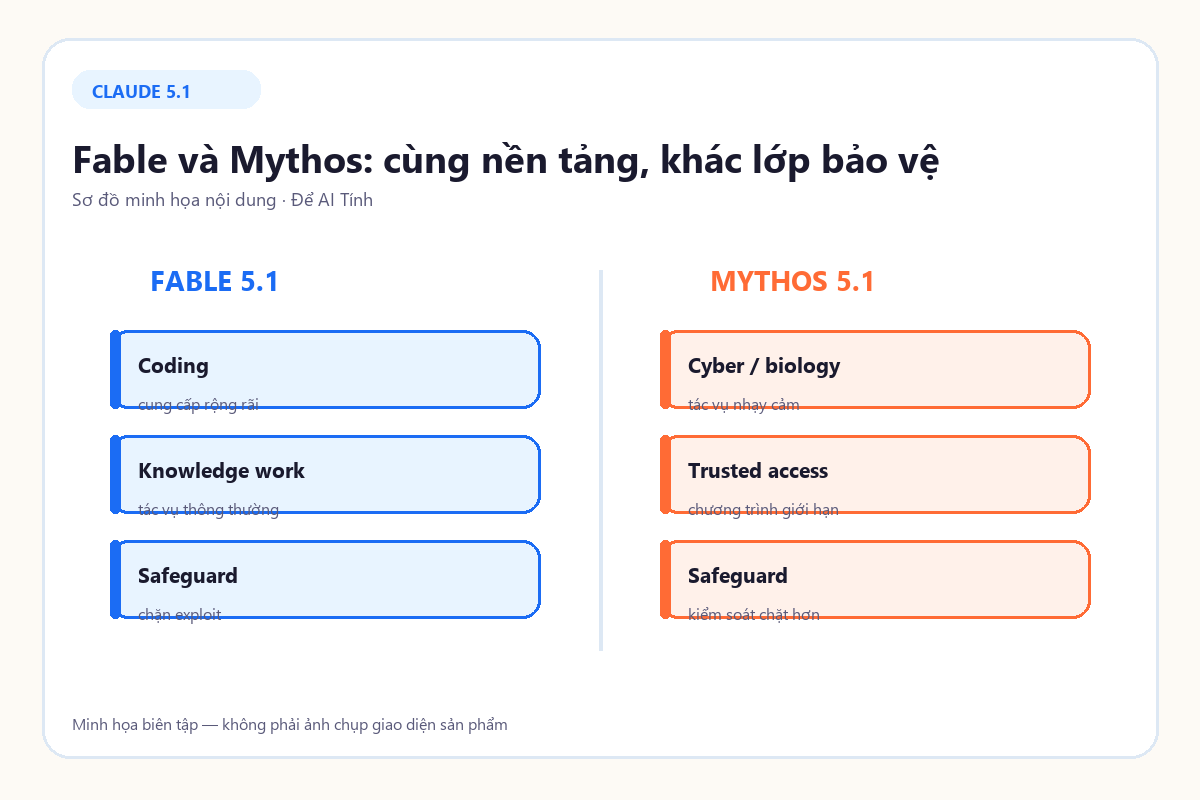
Ngày 1/9/2026, Anthropic giới thiệu Claude Fable 5.1 và Claude Mythos 5.1. Điểm đáng chú ý là hai tên gọi này không đại diện cho hai model hoàn toàn khác nhau: Anthropic nói chúng dùng cùng nền tảng, nhưng có mức safeguard khác nhau. Fable 5.1 được cung cấp rộng rãi cho coding và knowledge work; Mythos 5.1 chỉ dành cho các chương trình trusted access, tập trung vào an ninh mạng và khoa học sự sống.
Khác biệt nằm ở “cách triển khai”, không chỉ ở model
Anthropic cho biết Fable 5.1 có thể tìm lỗ hổng phần mềm nhưng không được dùng để phát triển exploit. Với sinh học, hãng lập chương trình tiếp cận cho Mythos 5.1 cùng chính phủ Mỹ. Đây là một cách tiếp cận đáng chú ý: thay vì chỉ công bố một model rồi để mọi người tự xử lý rủi ro, nhà cung cấp phân tầng quyền truy cập theo lĩnh vực và mức độ nhạy cảm.
Điều đó không có nghĩa safeguard đã giải quyết toàn bộ rủi ro. Quyền truy cập, công cụ bên ngoài, dữ liệu đưa vào và quy trình giám sát của khách hàng vẫn quyết định phần lớn mức an toàn thực tế.
Giá và dữ liệu: hai đòn bẩy cạnh tranh mới
Theo Anthropic, Fable 5.1 rẻ hơn khoảng 25% so với Fable 5 trong các workload tính theo token; với tác vụ agent nhiều bước, mức tiết kiệm có thể lên khoảng 45% nhờ giá cache read. Anthropic cũng công bố Enterprise Frontier Safeguards, trong đó dữ liệu được lưu trên hạ tầng cloud do khách hàng kiểm soát; tính năng này dự kiến mở theo từng giai đoạn từ cuối mùa thu.
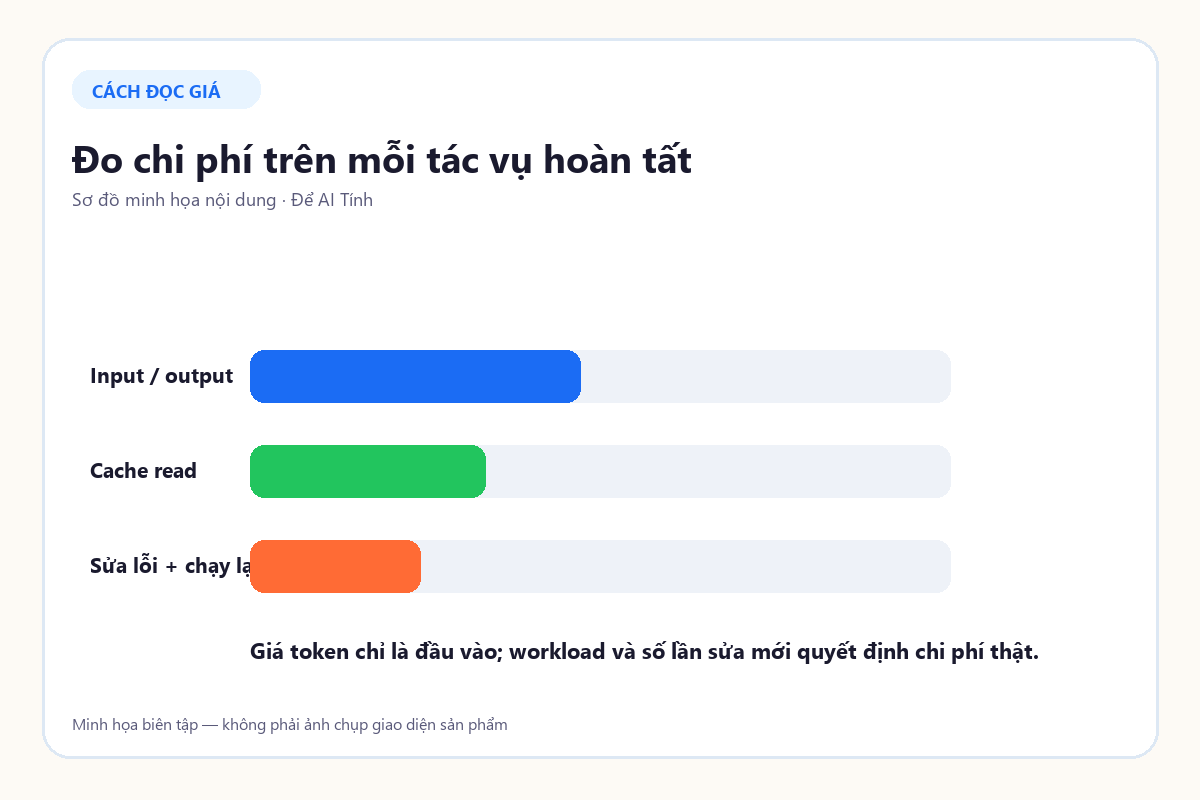
Các con số về giá là thông tin do Anthropic công bố và còn phụ thuộc loại workload, token, mức effort và công cụ đi kèm. Khi so sánh nhà cung cấp, nên đo chi phí trên mỗi tác vụ hoàn thành thay vì chỉ nhìn giá input/output.
Anthropic công bố gì về năng lực?
Anthropic trình bày kết quả trên các bài kiểm thử coding, nghiên cứu khoa học, computer use và knowledge work. Hãng cho biết Fable 5.1 cải thiện rõ rệt so với Fable 5 trên một số benchmark; Mythos 5.1 có kết quả cao hơn ở những tác vụ trước đây bị safeguard can thiệp. Trang công bố cũng ghi rõ một số kết quả bị ảnh hưởng bởi safeguard trong quá trình đánh giá.
Vì phần lớn benchmark và nhận xét đối tác đến từ chính Anthropic, nên cách đọc thận trọng là: Fable 5.1 cho thấy hướng đi “model mạnh + triển khai theo rủi ro”, còn mức độ phù hợp với hệ thống của bạn cần được kiểm thử riêng.
Doanh nghiệp nên dùng insight này thế nào?
- Tách model dùng cho công việc thông thường khỏi model được cấp quyền với dữ liệu hoặc công cụ nhạy cảm.
- Đo chất lượng theo task end-to-end: độ chính xác, số lần sửa, thời gian, token và tỷ lệ cần người can thiệp.
- Đưa chính sách lưu trữ, xóa dữ liệu và quyền audit vào hợp đồng, không chỉ xem trang pricing.
- Đánh giá false positive của safeguard vì từ chối quá nhiều cũng làm quy trình mất ổn định.
Với người làm nội dung, bài học đơn giản là đừng gọi một model là “tốt nhất” trong mọi việc. Hãy mô tả rõ nó tốt ở task nào, trong điều kiện nào và với mức kiểm soát nào.
Câu hỏi thường gặp
Claude Fable 5.1 và Mythos 5.1 khác nhau thế nào?
Hai phiên bản dùng cùng nền tảng nhưng có safeguard và quyền truy cập khác nhau. Fable được cung cấp rộng rãi; Mythos dành cho trusted access và tác vụ nhạy cảm hơn.
Có nên chọn model chỉ vì giá API thấp hơn?
Không nên. Cần đo chi phí trên mỗi tác vụ hoàn thành, bao gồm token, công cụ, số lần sửa, thời gian và mức độ con người phải can thiệp.
Nguồn tham khảo
Tư vấn, Trao đổi & Hợp tác
Bạn muốn ứng dụng AI vào công việc, đặt lịch coaching 1-1 hay hợp tác truyền thông? Hãy gửi thông tin cho tôi.