Giọng đọc AI tiếng Việt không còn lơ lớ: cách tôi dùng ElevenLabs cho video, phụ đề và lồng tiếng
Phần lớn giọng AI tiếng Việt nghe “Tây” không phải vì công cụ kém. Nó lơ lớ vì người dùng chọn sai thứ tự: chỉnh thanh trượt trước, chọn giọng sau. Với ElevenLabs, tôi làm ngược lại, và chất lượng khác hẳn.
Bài này gom lại những gì tôi rút ra sau một thời gian dùng ElevenLabs mỗi ngày cho video review, clip ngắn và sách nói. Không đi theo từng menu, mà theo bốn việc người làm nội dung thật sự cần: một giọng Việt tự nhiên, một giọng của riêng mình, phần âm thanh bao quanh giọng, và đưa nội dung sang định dạng khác. Ảnh giao diện tôi chụp ngày 18/10/2026; ElevenLabs đổi giao diện khá nhanh nên vị trí nút có thể đã xê dịch.
Trước khi bắt đầu: credit là thứ cần để mắt
Mọi lần tạo âm thanh đều trừ credit. Lúc tôi kiểm tra bảng giá ngày 18/10/2026, gói Free cho 10.000 credit mỗi tháng, gói trả phí rẻ nhất là Starter với 6 USD. Con số có thể khác theo khu vực và thời điểm, nên hãy xem lại trước khi nâng cấp.
Cách tiết kiệm đơn giản nhất: chốt giọng, model và cài đặt trên một câu mở đầu, rồi mới tạo cả bài. Tạo cả kịch bản 3 phút chỉ để phát hiện giọng không hợp là cách đốt credit nhanh nhất mà tôi biết.
Đăng nhập rất nhanh bằng tài khoản Google hoặc Apple. Nếu chưa có tài khoản, bạn có thể mở tài khoản ElevenLabs tại đây. Nên làm trên máy tính, vì bố cục web rộng và nhiều cột.
Muốn thử ngay trong lúc đọc? Mở ElevenLabs ở một tab bên cạnh và làm theo từng phần.
Dùng thử ElevenLabsViệc 1: một giọng Việt nghe như người thật
Giọng quyết định trước, model đứng thứ hai
Hướng dẫn Text to Speech của ElevenLabs xếp thứ tự ảnh hưởng rất rõ: giọng đọc trước tiên, sau đó tới model, các thanh chỉnh chỉ là phần tinh chỉnh cuối. Văn bản bạn gõ chỉ định đọc bằng thứ tiếng nào; cái hồn của giọng và cách nhả chữ lại nằm ở giọng bạn chọn. Đó là lý do một giọng gốc Anh đọc tiếng Việt luôn có cảm giác như người nước ngoài tập nói.
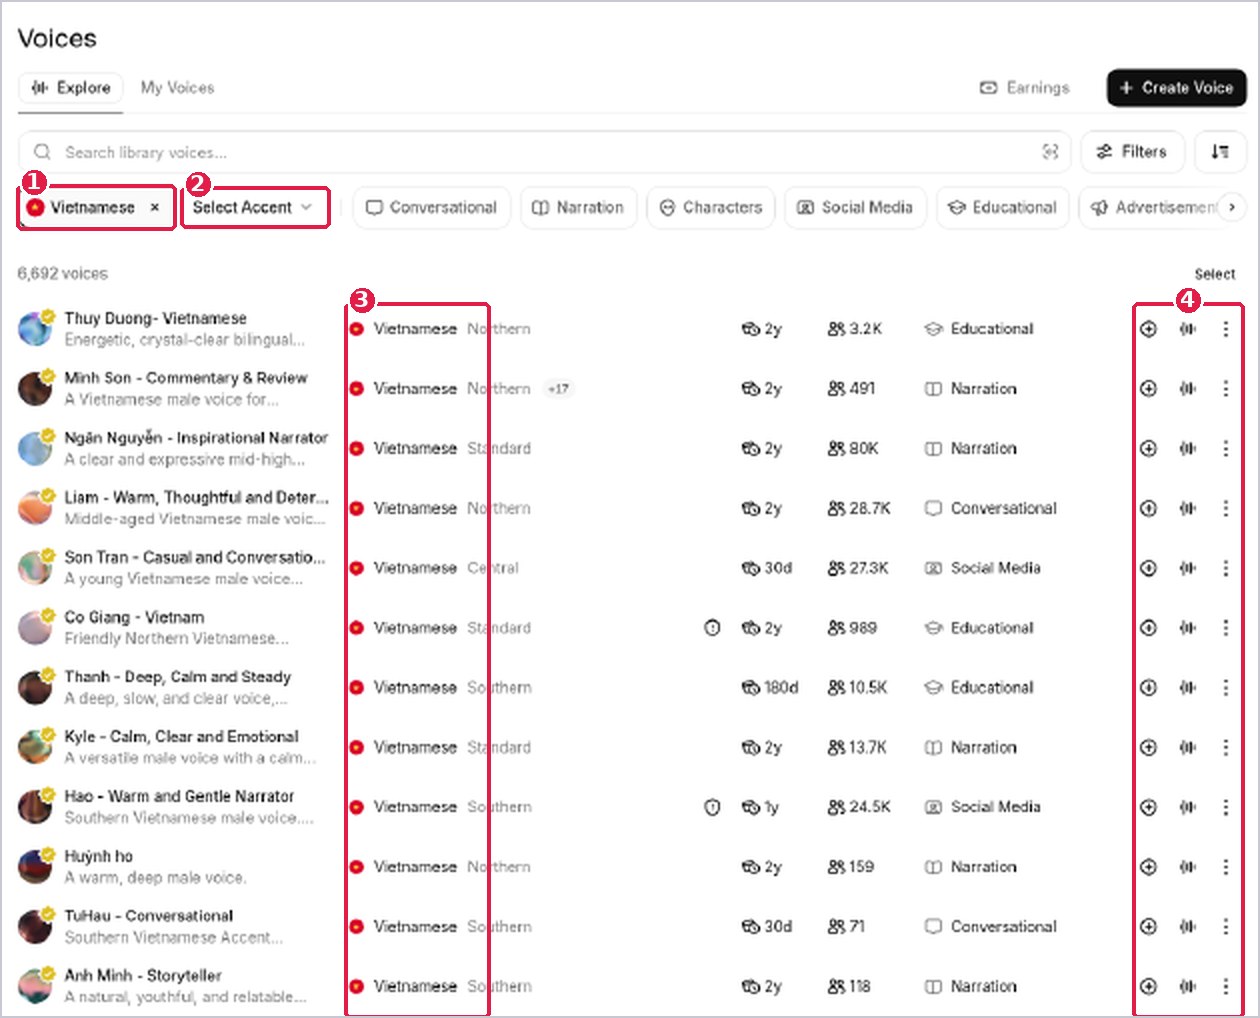
Vì thế tôi luôn mở mục Voices trước. Bấm nút Language, gõ Vietnamese, danh sách lọc còn toàn giọng Việt. Ngày tôi chụp có 6.692 giọng. Điểm đáng giá nhất là nút Select Accent: cạnh tên từng giọng có nhãn vùng miền (Northern, Central, Southern, Standard), nhờ vậy bạn chọn được giọng Bắc, Trung hay Nam đúng với khán giả của mình.
Hai mẹo nhỏ khi chọn giọng:
- Đoạn nghe thử mẫu thường là đoạn hay nhất của giọng đó. Đừng chốt theo mẫu; hãy đưa chính kịch bản của bạn vào Text to Speech để nghe.
- Đưa chuột lên tên giọng, thẻ mô tả sẽ hiện khoảng thời gian bạn được báo trước khi chủ giọng rút nó khỏi thư viện. Làm sách nói hay series dài thì chọn giọng có khoảng báo trước dài, tránh cảnh đang làm dở thì giọng biến mất.
Thực ra ngay trong màn hình Text to Speech, khi nhận ra văn bản tiếng Việt, ElevenLabs đã tự gợi ý ba giọng và nhắc nên dùng giọng Việt. Lời nhắc đó đúng, đừng bỏ qua.
Model và hai thanh trượt
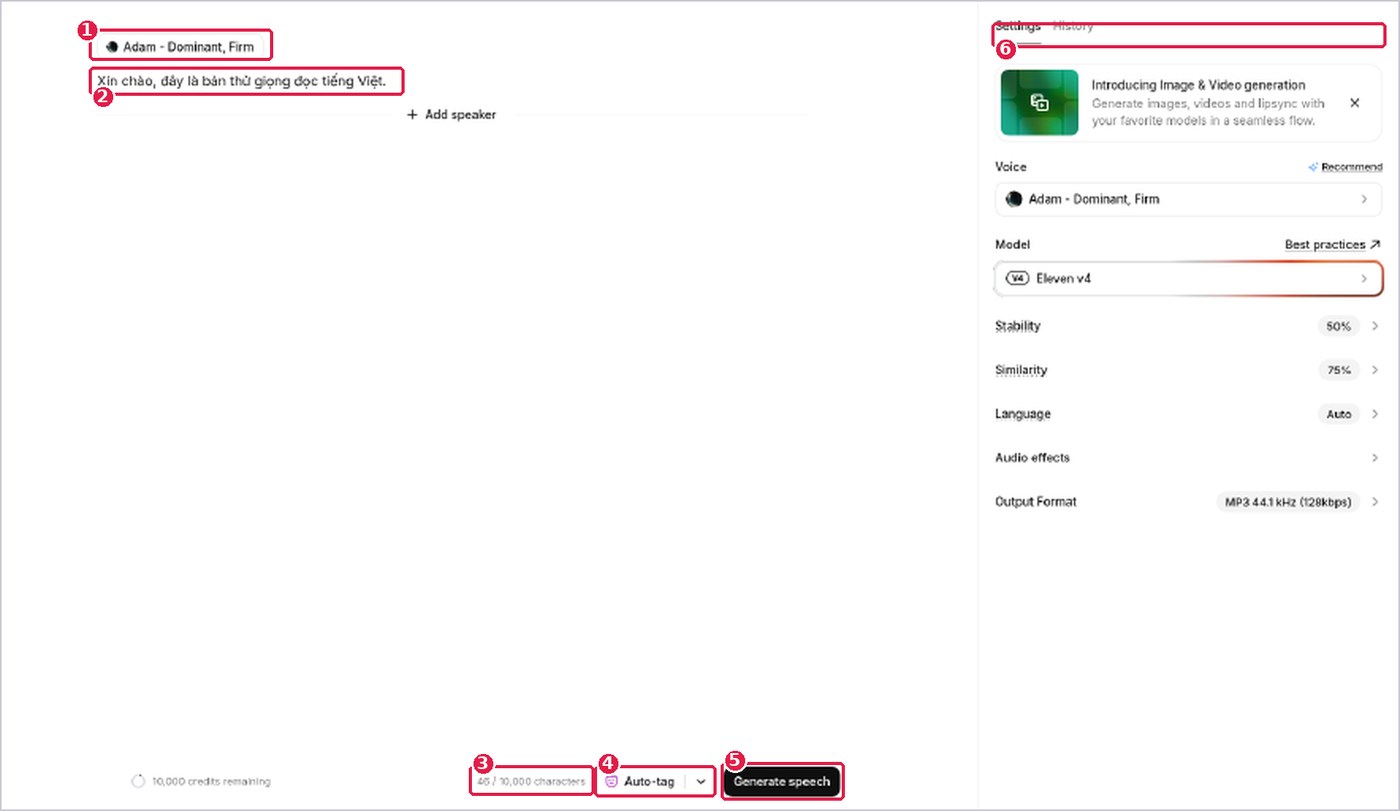
Mặc định của tôi cho tiếng Việt là Eleven v4. Trên giao diện, ElevenLabs tự nhận v4 là bản vừa nhanh nhất vừa biểu cảm nhất của họ, phủ trên 90 thứ tiếng. Nếu cần sự ổn định tuyệt đối cho voiceover dài, Eleven Multilingual v2 vẫn là lựa chọn an toàn; còn v3 biểu cảm mạnh nhưng đòi hỏi viết chỉ dẫn công phu hơn. Giới hạn cho một lượt tạo bằng v4 là 10.000 ký tự; kịch bản dài hơn thì chia đoạn hoặc chuyển sang Studio.
Với v4, bạn chỉ còn hai thanh để chỉnh:
- Stability (mặc định 50%): kéo sang Creative thì giọng bay hơn nhưng mỗi lần tạo một kiểu; kéo sang Robust thì đều, ổn định, đổi lại hơi phẳng.
- Similarity (mặc định 75%): càng cao càng bám sát giọng gốc, và bám luôn cả tạp âm nếu bản gốc thu không sạch.
Tôi giữ nguyên mặc định trong lần thử đầu, chỉ đụng tới khi nghe thấy vấn đề cụ thể. Mục Language cứ để Auto với văn bản thuần Việt. Định dạng xuất mặc định MP3 44.1 kHz 128kbps là đủ cho mạng xã hội; cần chất lượng cao hơn thì tab History cho tải WAV, mục Advanced còn có FLAC, M4A và MP3 bitrate cao.
Một chi tiết ít người biết: theo tài liệu chính thức, bạn có hai lượt tạo lại miễn phí trên web, với điều kiện chỉ xê dịch thanh trượt (văn bản, giọng, model để y nguyên), làm trong hai giờ và không refresh trang.
Ngoài ra còn mục Audio effects với bốn nhóm: Filter giả tiếng loa điện thoại hoặc radio đời cũ, Noise thêm tiếng ồn quán xá, đường phố, Space cho tiếng vọng của căn phòng hay bãi trống, Distance kéo người nói lại sát hoặc lùi ra xa micro. Theo ElevenLabs, các hiệu ứng này không làm tăng chi phí.
Viết cho máy đọc, không phải cho người đọc
Phần này quyết định nhiều hơn mọi thanh trượt. AI đọc đúng từng ký tự bạn gõ, nên:
- Số, giá tiền, ngày tháng: viết thành chữ theo cách bạn muốn nghe. “1.990.000đ” nên thành “một triệu chín trăm chín mươi nghìn đồng”.
- Bỏ emoji và ký hiệu lạ.
- Soát dấu thanh thật kỹ. Sai một dấu là AI đọc ra một từ khác.
- Nhịp nghỉ nằm ở dấu phẩy và dấu chấm. Câu quá dài sẽ bị đọc một hơi.
- Muốn cười, thở dài hay thì thầm, v4 và v3 hiểu các thẻ đặt giữa hai dấu ngoặc vuông: [laughs], [sighs], [whispers].
Việc 2: một giọng của riêng bạn
Khi thư viện không có giọng ưng ý, trang Voice Creation có bốn lối đi. Tôi tóm tắt theo nhu cầu chứ không theo thứ tự trên màn hình:
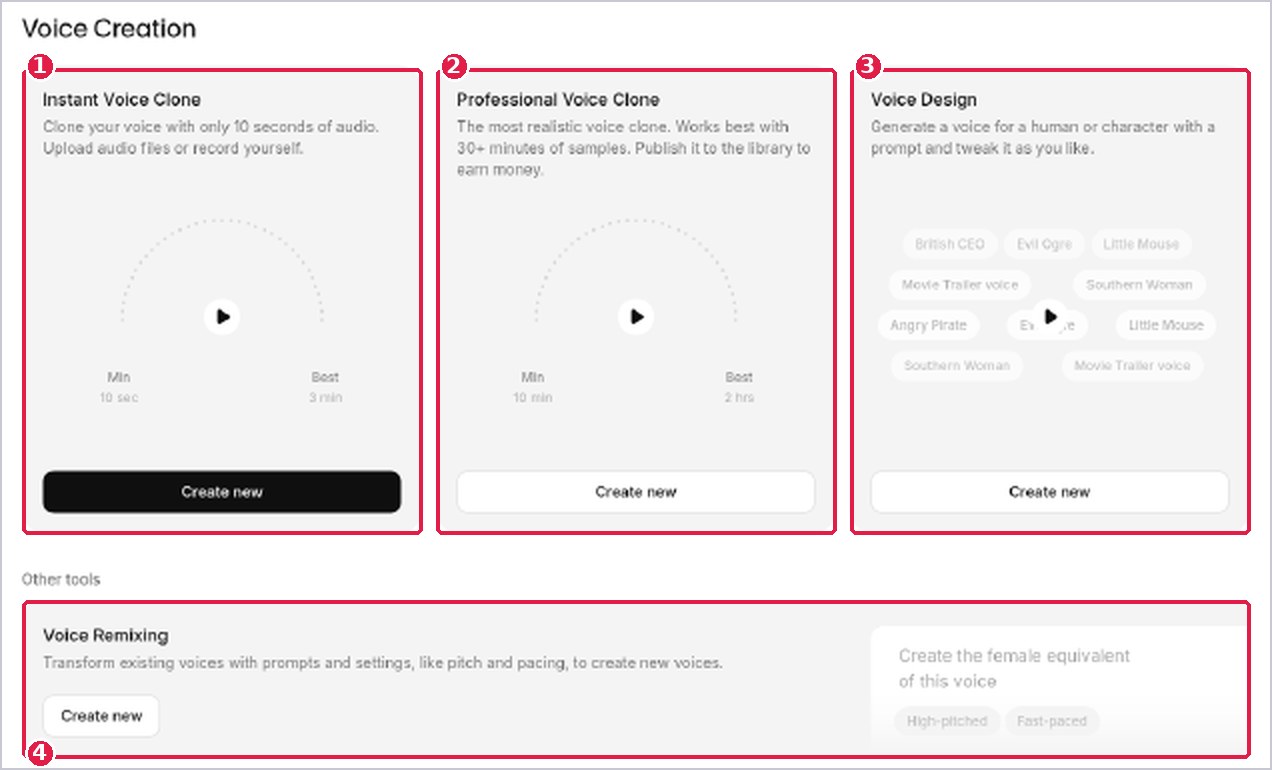
- Muốn có giọng ngay, không cần giống ai: Voice Design. Bạn tả bằng lời (giới tính, tuổi, vùng miền, chất giọng, tốc độ, cảm xúc) và có giọng trong chưa đầy một phút. Tả càng chi tiết, kết quả càng sát ý.
- Muốn giọng của chính mình, làm nhanh: Instant Voice Clone. Tối thiểu 10 giây âm thanh, đẹp nhất khoảng 3 phút, tải file hoặc thu thẳng.
- Muốn bản giống thật nhất: Professional Voice Clone. Cần từ 30 phút âm thanh sạch trở lên, lý tưởng khoảng 3 giờ, và phải từ gói Creator. Tài khoản miễn phí sẽ thấy mục này bị khóa.
- Muốn biến tấu một giọng sẵn có (cao hơn, nhanh hơn): Voice Remixing. Lưu ý công cụ này chạy trên giọng của chính bạn hoặc giọng có sẵn của hệ thống; giọng lấy từ thư viện cộng đồng thì không remix được.
Chất lượng bản nhân bản phụ thuộc gần như hoàn toàn vào file mẫu: căn phòng im ắng, chỉ một người lên tiếng, giọng to nhỏ ổn định, tắt hết nhạc. Và một nguyên tắc tôi không bao giờ bỏ qua: giọng được clone phải là của tôi, hoặc của người đã gật đầu cho phép, và tuyệt đối không mang đi mạo danh.
Việc 3: phần âm thanh quanh giọng đọc
Sound Effects
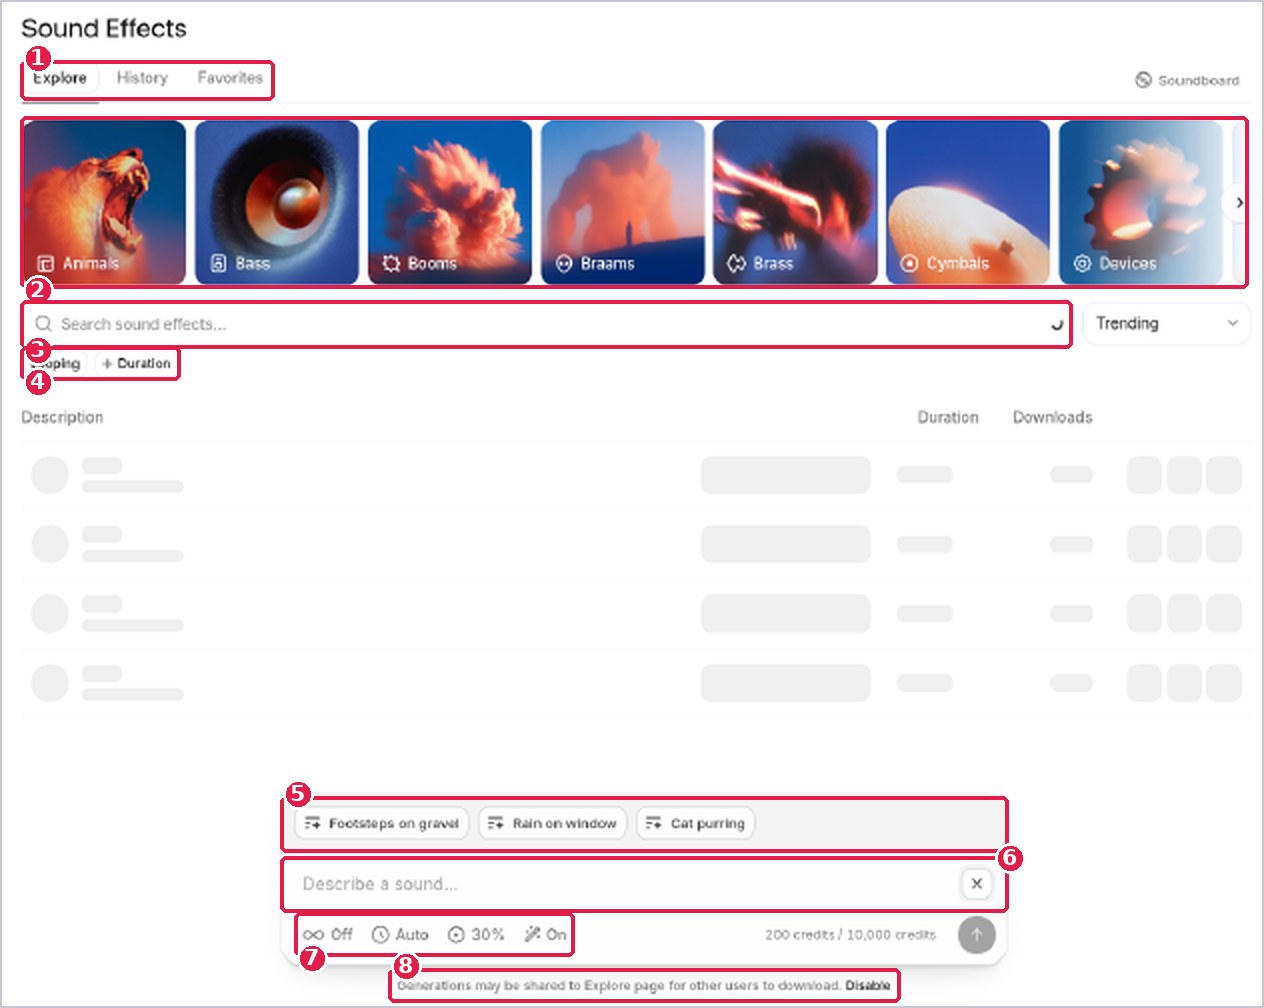
Tiếng bóc hộp, tiếng “ting” lúc giá hiện ra, tiếng mưa ngoài cửa sổ: gõ mô tả là có. Tài liệu Sound Effects nêu các giới hạn: mô tả dài nhất 450 ký tự, âm thanh dài nhất 30 giây (hoặc chọn Auto), Looping để tạo vòng lặp không đứt, và mức bám sát mô tả đặt sẵn ở 30%. Tôi viết prompt bằng tiếng Anh, ngắn và cụ thể. Mỗi lần tạo ra vài biến thể, nghe trong tab History rồi tải MP3 hoặc WAV.
Cần để ý dòng chữ nhỏ cuối màn hình: âm thanh bạn làm ra mặc định có thể xuất hiện ở Explore, ai cũng tải được. Làm cho khách hàng hoặc sản phẩm chưa ra mắt thì bấm Disable trước.
Music
Music tạo nhạc nền từ mô tả: dòng nhạc, cảm xúc, loại nhạc cụ, tốc độ, có hát hay chỉ hòa tấu, số phương án và thời lượng. Về bản quyền, chú thích trên trang cho biết tải về để dùng thương mại cần gói trả phí, và theo bảng giá thì quyền thương mại có từ gói Starter. Nhạc dùng cho kênh kiếm tiền hoặc quảng cáo thì đọc kỹ điều khoản gói đang dùng.
Voice Isolator và Voice Changer
Voice Isolator tách giọng ra khỏi tạp âm, nhận file tới 500MB hoặc 1 giờ theo tài liệu. Tôi dùng nó cho clip quay ngoài đường, bản ghi phỏng vấn lẫn tiếng quạt, tiếng xe. Nó cũng là cách cứu file mẫu trước khi nhân bản giọng. Nếu nhạc nền lấn giọng, bản lọc đôi khi bị méo nhẹ, vì vậy tôi luôn nghe lại trọn file.
Voice Changer giữ nguyên cách bạn diễn, chỉ thay sang giọng khác: hữu ích khi tự đọc có cảm xúc rồi đổi sang giọng nhân vật. Bản thu tối đa 5 phút, file tối đa 50MB. Riêng với tiếng Việt cần thận trọng: model mặc định lúc tôi chụp là Eleven English v2, chỉ cho tiếng Anh, còn Multilingual v2 theo tài liệu cũng chưa liệt kê tiếng Việt. Bấm vào ô model kiểm tra lựa chọn mới, và thử với vài giây trước đã.
Việc 4: đưa nội dung đi xa hơn
Speech to Text cho phụ đề
Thay vì gõ phụ đề tay, tôi đưa chính file giọng đọc vào Speech to Text, bật Include subtitles. Nguồn vào có thể là file tải lên (tới 1000MB), thu trực tiếp, link YouTube hoặc URL. Ô Keyterms là nơi tôi điền sẵn tên sản phẩm và thương hiệu để giảm lỗi chính tả, nhưng tên riêng và số liệu vẫn phải đọc lại bằng mắt.
Dubbing khi muốn ra thị trường khác
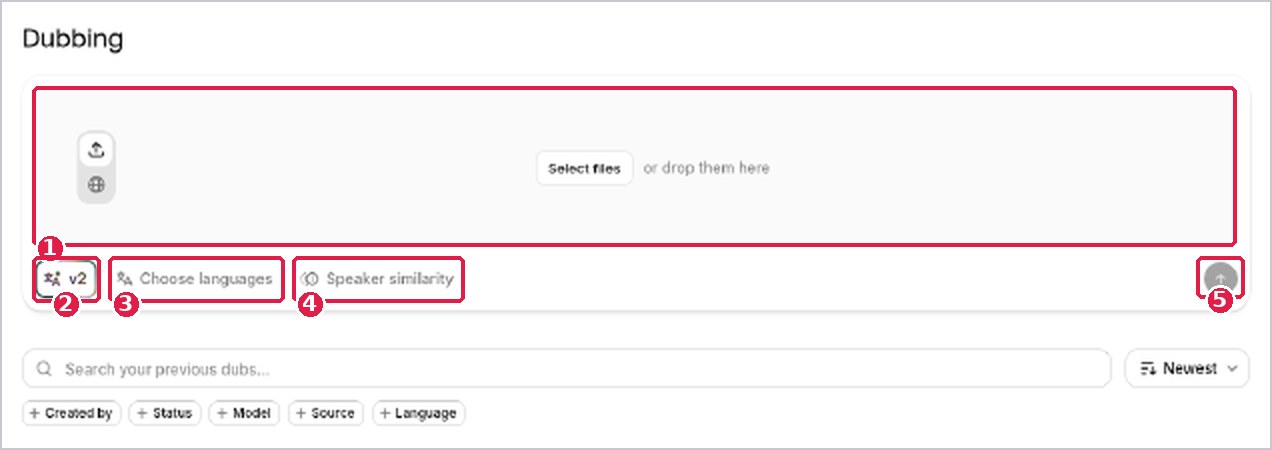
Dubbing v2 giữ được sắc thái của người nói ban đầu, chỉnh câu chữ cho tự nhiên và tự nhân bản giọng, trên 92 ngôn ngữ. Kết quả đẹp nhất khi video có một hai người nói, thu rõ tiếng, nhạc nền nhỏ. Tôi luôn lồng thử 30 đến 60 giây đầu, nghe kỹ phần tên riêng và thuật ngữ, rồi mới làm cả video.
Studio và Audiobooks cho nội dung dài
Kịch bản dài thì dựng trong Studio: chia đoạn, gán giọng từng đoạn, sửa đoạn nào tạo lại đoạn đó, không phải làm lại cả bài. Studio còn có các công cụ phụ như thêm phụ đề tự động, thêm giọng đọc vào video, tạo nhạc theo video và đổi ngôn ngữ video.
Audiobooks dành cho sách nói, có Character Casting để mỗi nhân vật một giọng, và có lựa chọn xuất bản lên ứng dụng ElevenReader. Lời khuyên của tôi: làm trọn chương một, ghi lại mọi chữ bị đọc sai, viết lại những chữ đó cho đúng cách đọc, rồi mới chạy cả cuốn. Và chỉ chuyển thành sách nói những cuốn bạn sở hữu bản quyền hoặc được tác giả đồng ý.
Image & Video, Flows, Chat
ElevenLabs giờ không chỉ là âm thanh. Image & Video có tab Lip sync ghép giọng với avatar cho khớp khẩu hình, Flows là bảng vẽ để xâu chuỗi các khâu ảnh, video, tiếng thành dây chuyền, còn Chat (bản Alpha) nhận yêu cầu bạn gõ như nói chuyện. Kho model video thay đổi liên tục. Changelog cho biết cuối tháng 9/2026 hãng đã rút Sora 2 cùng Sora 2 Pro, và Seedance 1.5 Pro sẽ tắt vào 11/11/2026.
Quy trình 6 bước tôi dùng cho một video review
- Viết kịch bản, đọc to một lượt để cắt câu dài, đổi số thành chữ.
- Lọc giọng Vietnamese theo vùng miền của khán giả, lưu hai hoặc ba ứng viên vào My Voices.
- Thử từng ứng viên bằng đúng câu mở bài trên Eleven v4, cài đặt mặc định, chốt một giọng.
- Tạo giọng theo đoạn; kịch bản dài thì chuyển qua Studio.
- Rắc vài hiệu ứng ngắn vào lúc bóc hộp, lúc giá xuất hiện; làm thêm nhạc nền, nhớ soát quyền dùng thương mại.
- Cho file giọng qua Speech to Text để có phụ đề, cuối cùng ráp mọi thứ trên phần mềm dựng video.
Đây là thói quen cá nhân của tôi, không phải quy trình do ElevenLabs đưa ra.
Năm cập nhật đáng biết của mùa thu 2026
- 10/08: lập trình viên gọi được Dubbing v2 qua API, từng người nói vẫn giữ chất giọng và nhịp riêng (changelog).
- 28/09: Eleven v4 và v4 Turbo ra mắt, hơn 90 ngôn ngữ, bám thẻ cảm xúc tốt hơn (blog ElevenLabs).
- 09/10: Brand Kit, nơi cất logo, bảng màu, font, ảnh mẫu, luật dùng thương hiệu; gõ @ là kéo kit vào câu lệnh trong Image & Video hay Flows (giới thiệu Brand Kit).
- 12/10: bản API của Text to Speech có thêm tùy chọn audio effects, chi phí giữ nguyên (changelog).
- 15/10: Instant Soundtracks, tải video lên là có nhạc nền và hiệu ứng đặt đúng mốc (giới thiệu Instant Soundtracks).
Sáu lỗi hay gặp và cách xử lý
- Giọng lơ lớ: đang dùng giọng gốc Anh. Đổi sang giọng có nhãn Vietnamese.
- Đọc sai số, viết tắt: viết lại thành chữ.
- Mỗi lần tạo một kiểu: kéo Stability về Robust, tạo vài bản rồi chọn.
- Giọng nhân bản rè: file mẫu bẩn. Thu lại nơi yên tĩnh hoặc lọc qua Voice Isolator.
- Không tìm thấy nút như trong ảnh: giao diện đã đổi. Gõ tên tính năng vào ô Search everything trên cùng, hoặc tra Docs.
- Hiệu ứng làm cho khách lại hiện trên Explore: quên bấm Disable chia sẻ.
Muốn đi sâu hơn
Bài này là bản rút gọn. Nếu bạn muốn hướng dẫn đủ từng màn hình, tôi có ebook ElevenLabs toàn tập 2026 51 trang, 18 chương, tải miễn phí trên Để AI Tính.
Ebook ElevenLabs toàn tập 2026
51 trang, 18 chương, ảnh giao diện từng bước. Tải miễn phí.
Đọc và tải ebookMở ElevenLabsHoàng Nhật Mai – Founder hệ thống Để AI Tính
Giá, giới hạn và tính năng trong bài lấy từ trang chính thức của ElevenLabs, truy cập ngày 18/10/2026. Ảnh minh họa chụp từ giao diện ElevenLabs cùng ngày.
Tư vấn, Trao đổi & Hợp tác
Bạn muốn ứng dụng AI vào công việc, đặt lịch coaching 1-1 hay hợp tác truyền thông? Hãy gửi thông tin cho tôi.
Công cụ AI liên quan
Tin liên quan
Muse toàn tập 2026: hướng dẫn từng bước dùng trợ lý AI cá nhân có máy ảo riêng và 35 kịch bản mẫu
📅 24/10/2026
Grok Bot toàn tập 2026: hướng dẫn từng bước dùng đội bot AI cho người làm nội dung tiếng Việt
📅 20/10/2026
ElevenLabs toàn tập 2026: hướng dẫn từng bước dùng AI giọng nói cho người làm nội dung tiếng Việt
📅 20/10/2026